La segmentation d’images est la forme d’annotation la plus exigeante que l’on puisse demander à un opérateur humain : chaque pixel reçoit une appartenance, et tout ce qui n’est pas décidé explicitement devient une erreur implicite. Une bounding box tolère l’approximation par construction ; un masque ne la tolère pas, parce que son contour est lui-même le livrable. C’est ce qui fait de la segmentation d’images une opération à part dans un projet de computer vision, et c’est ce qui explique que les projets qui y recourent échouent rarement sur la technique et fréquemment sur le cadrage.
Cet article ouvre une série de quinze textes consacrés à la segmentation d’images. Il en pose le vocabulaire, les trois formes principales, les décisions qui se prennent avant la première image annotée, les postes de coût, les méthodes de contrôle et les limites structurelles que le lecteur doit connaître avant de s’engager. Les articles suivants approfondissent chacun de ces points ; le présent guide se contente de les ordonner. Il prolonge le guide général de l’annotation d’images, dont il détaille la famille la plus dense, et il annonce le comparatif consacré au choix entre segmentation sémantique et segmentation d’instances.
Ce que la segmentation d’images désigne exactement
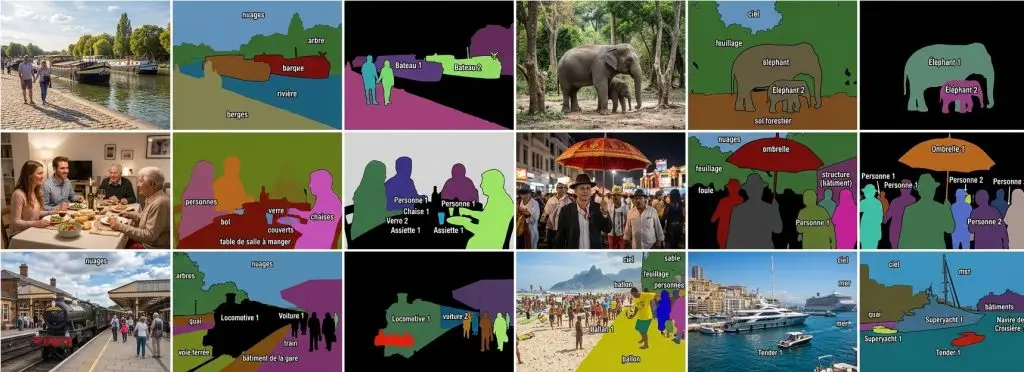
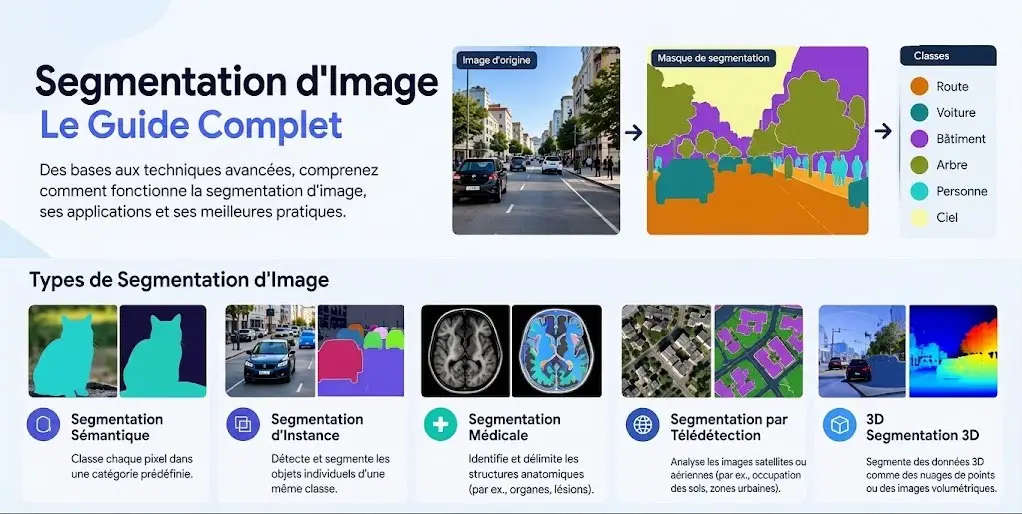
La segmentation d’images consiste à attribuer une étiquette à chaque pixel d’une image, de sorte que l’image entière soit partitionnée en régions dont chacune porte une signification. Elle se distingue de la détection, qui localise sans délimiter, et de la classification, qui qualifie sans localiser. Trois propriétés définissent ce que produit une segmentation d’images, et elles déterminent à elles seules la difficulté du travail. La couverture est exhaustive. Une détection peut ignorer l’arrière-plan ; une segmentation doit statuer sur lui, ne serait-ce qu’en lui affectant une classe résiduelle. Il n’existe pas de pixel sans décision, ce qui signifie que l’annotateur ne peut pas réserver son effort aux zones qui l’intéressent. Le contour est le produit. Dans une bounding box, le rectangle est une approximation acceptée dont on sait qu’elle contient du fond. Dans un masque, la frontière entre deux régions est précisément ce que le modèle apprendra à reproduire, et une frontière tracée à trois pixels de la limite réelle enseigne au modèle une limite fausse. La résolution fixe la granularité minimale. Une structure plus fine que le pixel ne peut pas être segmentée, quelle que soit la compétence de l’opérateur. Cette borne physique est souvent oubliée dans les cahiers des charges, qui décrivent des classes que l’image ne permet pas de distinguer. Une conséquence pratique s’ensuit. La segmentation d’images n’est pas une bounding box plus précise ; c’est une opération d’une nature différente, dans laquelle l’erreur ne se mesure plus par la présence ou l’absence d’un objet mais par la position de chaque pixel de sa frontière. Tout ce qui suit dans cette série découle de ce déplacement.Segmentation sémantique, segmentation d’instances, segmentation panoptique
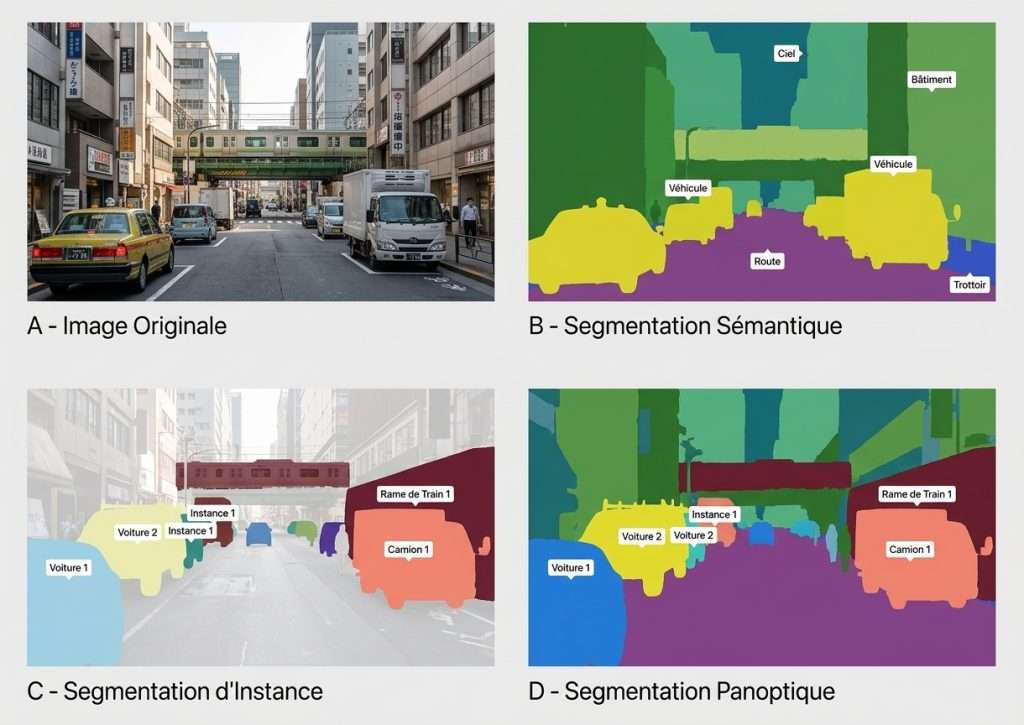
Ces trois formes répondent à trois questions distinctes, et le choix entre elles est la première décision d’un projet de segmentation d’images. Le comparatif détaillé fait l’objet du deuxième article de la série ; ce qui suit en fixe les définitions et les conséquences immédiates pour la production. La segmentation sémantique répond à la question « quelle est la nature de ce pixel ». Tous les pixels d’une même classe reçoivent la même étiquette, sans distinction entre les objets. Deux véhicules qui se touchent forment une seule région « véhicule ». Cette forme convient aux régions amorphes, que la littérature appelle « stuff » : route, végétation, ciel, eau, tas de matériau en vrac. En production, elle est la plus rapide à annoter par surface couverte, parce que l’opérateur n’a pas à séparer ce qui se touche. La segmentation d’instances répond à la question « quel objet est-ce ». Chaque objet dénombrable reçoit son propre masque, même s’il partage sa classe avec son voisin. Cette forme convient aux objets comptables, dits « things » : fruits dans une caisse, colis sur un convoyeur, cellules, véhicules. Elle impose de trancher les occlusions et les contacts, ce qui multiplie les décisions de frontière et donc le temps et le risque de désaccord. La segmentation panoptique combine les deux : chaque pixel reçoit une classe, et les pixels des classes dénombrables reçoivent en plus un identifiant d’instance. Elle produit une lecture complète de la scène et sert principalement aux systèmes de perception embarquée. Son coût d’annotation est la somme des deux précédentes, et sa cohérence est plus difficile à garantir, parce qu’un même pixel ne peut appartenir qu’à une seule instance. Le troisième article lui est consacré. Une observation mérite d’être ajoutée. Ces trois formes ne sont pas trois niveaux de qualité, et la panoptique n’est pas « la meilleure ». Elles répondent à des usages différents, et l’usage précède la méthode : un projet de comptage a besoin d’instances, un projet de surface a besoin de sémantique, et demander la panoptique par prudence revient à payer une information que le modèle final n’exploitera pas.Ce qui se décide avant la première image
La plupart des difficultés d’un projet de segmentation d’images se présentent au cadrage, et elles se découvrent à la livraison quand personne ne les a posées. Cinq questions structurent une réunion de cadrage. Que devient un pixel ambigu. Une image contient toujours des zones dont l’appartenance est indécidable à la résolution disponible : un bord flou, une ombre portée, une transition progressive entre deux matériaux. La réponse doit être écrite, sous la forme d’une convention de frontière, avant que le premier opérateur ne rencontre le cas. Sans convention, chaque annotateur tranche seul, et le désaccord entre eux devient la borne de qualité du corpus. Que devient la partie cachée d’un objet. En segmentation d’instances, un objet partiellement occulté peut être annoté sur sa partie visible ou reconstitué dans sa forme complète par inférence. Les deux choix sont défendables, produisent des corpus incompatibles, et changent le temps d’annotation dans un rapport significatif. Sur un projet de phénotypage végétal, la reconstitution des plants occultés a été retenue parce que la mesure de surface exigeait la forme entière ; sur un projet de convoyeur logistique, seule la partie visible était annotée, avec un attribut de degré de recouvrement. La question ne se règle pas par un principe général mais par l’usage. Quelle est la classe résiduelle. Tout ce qui n’entre dans aucune classe utile doit aller quelque part. Une classe « autre » mal définie absorbe les hésitations et devient la classe majoritaire, ce qui dégrade tout ce que l’on mesure dessus. Sa définition mérite autant de soin que celle des classes d’intérêt. Quel est le niveau de fidélité au contour. Un masque peut suivre chaque pixel de la limite réelle ou l’approcher par un polygone à quelques dizaines de sommets. L’écart entre les deux se mesure en temps d’annotation, dans un rapport qui varie du simple au triple selon la complexité des formes, et en tolérance du modèle, qui n’a pas toujours besoin de la fidélité maximale. Que fait-on des images inexploitables. Une part de toute collecte est floue, surexposée, mal cadrée ou vide. La décision de les segmenter quand même, de les écarter, ou de les annoter d’une étiquette d’image seule change le volume facturable et la représentativité du corpus. Elle doit être prise avant le devis, parce qu’elle en modifie l’assiette. Cela emporte une conséquence commerciale pour un prestataire. Un cahier des charges de segmentation d’images qui ne répond pas à ces cinq questions n’est pas encore chiffrable, et un devis établi sans ces réponses porte un risque qu’aucune marge ne couvre. La bonne pratique consiste à traiter ces questions sur un échantillon réel avant tout engagement de volume, ce que la série appellera systématiquement le pilote.Ce que la segmentation d’images change pour l’annotation
La lecture inverse est instructive : plutôt que de décrire ce que la segmentation apporte au modèle, il faut décrire ce qu’elle impose au travail de production. Quatre effets se constatent sur tout projet. Le temps par image cesse d’être prévisible à partir du nombre d’objets. En détection, dix objets coûtent dix rectangles. En segmentation d’images, dix objets coûtent dix contours dont la longueur et la complexité varient d’un facteur dix. Une plaque de 320 électrodes industrielles portant chacune quelques micro-défauts filiformes ne se chiffre pas comme dix fruits dans une caisse, alors que le nombre d’objets pourrait être comparable. La fatigue dégrade la qualité de manière mesurable. Un contour tracé en fin de session est moins fidèle qu’un contour tracé en début de session, et cette dérive n’apparaît sur aucun indicateur global. Elle impose des rotations de tâches et des contrôles répartis dans la journée plutôt qu’en fin de lot. Le désaccord entre annotateurs devient la mesure centrale. Deux opérateurs compétents ne tracent jamais exactement le même contour. L’écart entre leurs masques sur un même échantillon constitue la limite de ce qu’un modèle pourra apprendre, et c’est la seule référence qui permette de répondre à une exigence de qualité par un fait. Ce constat rejoint celui des séries précédentes, formulé dans des domaines aux contraintes opposées, du LiDAR aérien à l’imagerie médicale. L’outillage compte plus que partout ailleurs. Un outil sans pinceau ajustable, sans contour magnétique, sans gestion des chevauchements et sans visualisation par classe multiplie le temps par un facteur que l’on découvre trop tard. Les formats de sortie, masques matriciels ou polygones, engagent l’outil dès le départ ; l’article consacré aux formats y revient. Une conséquence pratique en résulte. Le pilotage d’un projet de segmentation d’images se fait à la surface annotée et au désaccord mesuré, pas au nombre d’images traitées. Un tableau de bord qui compte des images ne voit rien de ce qui détermine la qualité.Les postes de coût d’une segmentation d’images
Le neuvième article explique pourquoi la segmentation coûte plus cher que la bounding box ; ce qui suit se limite à nommer les postes, dont plusieurs sont rarement budgétés. Six postes composent le coût d’un projet. Le cadrage et le pilote. Les cinq questions exposées plus haut se traitent sur un échantillon, avec des allers-retours entre le client et le prestataire. Ce poste est fixe, indépendant du volume, et c’est celui qui détermine si les cinq suivants seront maîtrisés. La rédaction et la maintenance du guide d’annotation. Un guide de segmentation contient des exemples visuels de chaque convention de frontière, pas seulement des définitions. Il évolue pendant la production, à mesure que les cas non prévus apparaissent, et cette évolution doit être versionnée. L’annotation elle-même. C’est le poste que tout le monde chiffre, et souvent le seul. Il dépend de la surface à couvrir, de la complexité des contours, du nombre de classes et de la forme de segmentation retenue. Le contrôle qualité. Une segmentation se vérifie en repassant sur le contour, ce qui coûte une fraction significative du temps d’annotation initial. Un contrôle qui se limite à la classe, sans vérifier la frontière, ne contrôle pas la segmentation. La reprise. Une part du corpus revient en correction après contrôle. Cette part est faible sur un projet bien cadré et peut devenir majoritaire sur un projet dont la convention a changé en cours de route. La documentation de livraison. Rapport de qualité, journal des cas problématiques, version du guide appliquée : ces documents se rédigent pendant le travail et ne se reconstituent pas après, comme les séries précédentes l’ont établi à chaque fois. Cette gradation conduit à une observation. Le rapport entre le premier poste et les cinq autres est inversé par rapport à ce que l’on intuite : le cadrage est le poste le moins coûteux et le plus déterminant. Une fausse économie sur le pilote se paie en reprise, à un multiple que personne ne budgète.Contrôler une segmentation d’images
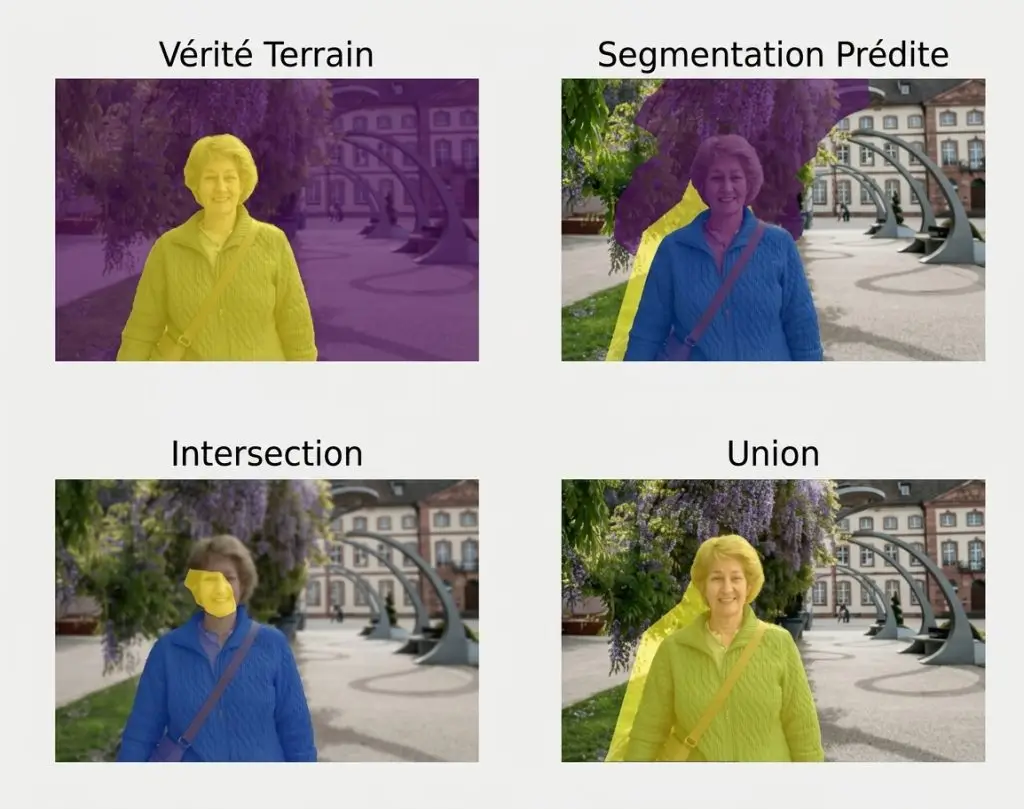
Le dixième article traite des métriques ; celui-ci se limite aux vérifications qu’un donneur d’ordre peut mener sans compétence technique particulière, classées par rendement décroissant. Quatre vérifications suffisent pour se faire une opinion fondée en une heure. Superposer le masque à l’image à fort grossissement, sur dix images tirées au hasard. Un contour qui déborde ou qui mord sur l’objet se voit immédiatement. Cette vérification prend quelques minutes et révèle les défauts de fidélité, qui sont les plus fréquents. Visualiser une seule classe à la fois sur l’ensemble du lot. Une classe qui apparaît là où elle ne devrait pas, ou qui manque là où l’image la montre, signale une confusion de nomenclature ou un cas non couvert par le guide. Cette vue par classe est ce qui échappe à tout indicateur global. Comparer deux annotateurs sur les mêmes images. Si le prestataire ne peut pas fournir cette comparaison, il ne mesure pas son propre désaccord, et sa promesse de qualité n’a pas de référence. Si l’écart est important, la convention de frontière est insuffisante, quelle que soit la compétence des opérateurs. Lire le journal des cas problématiques. Un projet de segmentation d’images qui n’a rencontré aucun cas ambigu n’existe pas. Un journal vide signifie que les ambiguïtés ont été tranchées silencieusement, chacune à la manière de l’opérateur qui l’a rencontrée. Un effet pratique en résulte. Ces quatre vérifications ne remplacent pas une métrique, mais elles la précèdent : un indicateur de recouvrement élevé sur un lot qui échoue à la deuxième vérification mesure un corpus dont les erreurs se concentrent sur une classe minoritaire. C’est exactement l’insuffisance que la série sur la segmentation d’images satellites a exposée, et elle vaut ici sans modification.Ce que la segmentation d’images ne résout pas
Une segmentation parfaite ne produit pas un modèle parfait, et plusieurs attentes fréquentes portent sur des points que la segmentation ne détermine pas. Quatre limites méritent d’être posées avant l’engagement. La segmentation ne corrige pas l’acquisition. Une image floue, sous-exposée ou prise sous un angle qui masque la structure d’intérêt reste inexploitable après segmentation. Un projet de segmentation d’instances en entrepôt sur imagerie infrarouge s’est heurté à des zones saturées au premier plan et obscures en profondeur : aucune convention de frontière ne restitue une limite que le capteur n’a pas enregistrée. Ce défaut relève de l’acquisition, et il se traite par une nouvelle collecte, pas par une annotation plus soignée. La segmentation ne crée pas de la diversité. Un corpus de dix mille images segmentées prises dans les mêmes conditions apprend au modèle ces conditions. La diversité se décide à la collecte, et le quatorzième article de la série y est consacré. La segmentation ne dépasse pas la résolution. Une structure plus fine que le pixel, un conducteur électrique vu de loin, un copeau métallique de la largeur d’un cheveu sur une image de plaque entière, ne peut être segmentée que par approximation, et cette approximation enseigne au modèle une forme qui n’existe pas. La série sur le LiDAR aérien a établi le même constat pour une donnée d’une nature entièrement différente. La segmentation ne remplace pas la définition de ce que l’on mesure. C’est la constante de toutes les séries de ce corpus : le facteur limitant n’est pas la donnée, ni les modèles, ni les outils, mais la définition documentée de ce que l’on cherche et la référence qui permet de l’évaluer. Une segmentation d’images exécutée sans cette définition est un travail précis sur un objet flou. Une conséquence en découle pour la lecture des articles suivants. Chacun d’eux traite d’un moyen d’améliorer une segmentation ; aucun ne lève ces quatre limites, parce qu’elles ne relèvent pas de la segmentation. Un lecteur qui les identifie dans son propre projet avant de commencer économise l’essentiel de ce que les erreurs classiques coûtent.Les outils d’assistance et leur portée réelle
Les modèles de segmentation générique, dont le cinquième article détaille l’apport, ont changé la façon dont un masque se produit. Il faut en dire ici ce que la production constate, sans anticiper l’analyse complète. Ces outils produisent un masque initial à partir d’un clic ou d’un rectangle, et ce masque est souvent bon sur un objet bien contrasté, isolé, aux contours nets. Il est médiocre sur un objet partiellement occulté, sur une région amorphe sans bord franc, sur une structure fine, sur un contact entre deux objets de même texture. Autrement dit, il accélère le travail facile et laisse intact le difficile, ce que la série sur la segmentation satellite avait déjà noté pour d’autres outils d’assistance. Trois effets en résultent pour un projet. Le temps moyen par image baisse, mais la variance augmente, parce que les images difficiles ne bénéficient d’aucun gain. La qualité du contour dépend de la vigilance de l’opérateur, qui doit corriger un masque plausible plutôt que tracer un masque depuis rien, et la correction d’un contour presque juste est cognitivement plus exigeante que le tracé initial. Enfin, la convention de frontière devient plus importante, pas moins, parce que l’outil produit une frontière qui n’est pas celle du guide et que l’opérateur doit savoir laquelle prévaut. Un constat complète ce point. Un prestataire qui présente l’assistance automatique comme une réduction uniforme du coût n’a pas mesuré la variance ; un prestataire qui la refuse par principe se prive d’un gain réel sur la moitié facile du corpus. La bonne position est intermédiaire et se mesure sur le pilote.Les signaux d’alerte à la lecture d’un cahier des charges
Certains signes, repérables sans compétence technique, annoncent un projet de segmentation d’images qui rencontrera des difficultés. Cinq d’entre eux reviennent assez souvent pour mériter d’être nommés. Une exigence de qualité exprimée en pourcentage sans définition de la métrique ni de la référence. « 95 % de précision » ne signifie rien en segmentation tant que l’on n’a pas dit précision de quoi, mesurée comment, contre quelle vérité terrain. Une nomenclature de plus de quinze classes sans exemple visuel pour chacune. Le nombre de classes n’est pas le problème ; l’absence d’exemples l’est, parce qu’elle laisse aux opérateurs le soin de fixer les frontières entre classes voisines. Un volume exprimé en images sans indication de la densité d’objets ni de la complexité des contours. Mille images de ciel et mille images de foule ne se chiffrent pas dans le même ordre de grandeur. Une demande de segmentation panoptique sans justification par l’usage. Elle signale souvent une prudence qui coûte le prix des deux segmentations pour un modèle qui n’en exploitera qu’une. Une absence de réponse à la question de l’occlusion. Si le cahier des charges ne dit pas ce que devient la partie cachée d’un objet, la réponse sera donnée par chaque annotateur, et le corpus contiendra les deux conventions. Une conséquence commerciale s’ensuit. Ces signaux ne disqualifient pas un projet ; ils indiquent que le cadrage n’a pas eu lieu. La réponse adaptée n’est pas un devis mais une proposition de pilote qui produira les réponses manquantes.Comment les quatorze articles suivants s’articulent
Ce guide ordonne ce que la série développe. Il est utile d’en décrire la progression, parce que l’ordre de lecture suit l’ordre des décisions d’un projet. Les articles deux et trois traitent du choix de la forme : sémantique ou instances, puis panoptique. L’article quatre traite des méthodes de tracé et de la précision au pixel. L’article cinq traite de l’assistance automatique. Les articles six, sept et huit traitent de trois domaines où la segmentation d’images prend des exigences particulières : médical, satellite et aérien, conduite autonome. L’article neuf traite du coût, l’article dix de la mesure de qualité, l’article onze des formats et des outils. L’article douze recense les erreurs, l’article treize traite des petits objets et des structures fines, l’article quatorze de la conception du dataset, et l’article quinze de la prospective. Les articles sectoriels renvoient aux séries déjà publiées sur la segmentation médicale et la segmentation satellite, qu’ils ne redémontrent pas : ils se limitent à ce que la segmentation générique doit apprendre de ces domaines. Cette économie de démonstration est ce qui permet à la série de tenir en quinze textes sans redite.Erreurs fréquentes en segmentation d’images
- Choisir la forme de segmentation avant d’avoir défini l’usage du modèle.
- Lancer la production sans convention de frontière écrite et illustrée.
- Laisser la question de l’occlusion sans réponse dans le guide.
- Définir une classe résiduelle vague qui absorbe les hésitations.
- Exiger une fidélité au contour que la résolution ne permet pas.
- Chiffrer au nombre d’images sans mesurer la densité ni la complexité.
- Contrôler la classe sans contrôler la frontière.
- Se fier à un indicateur global sans lecture par classe.
- Ne pas mesurer le désaccord entre annotateurs sur un échantillon commun.
- Traiter l’assistance automatique comme une réduction uniforme du temps.
- Modifier la convention en cours de production sans reprendre l’existant.
- Livrer les masques sans le guide versionné ni le journal des cas problématiques.