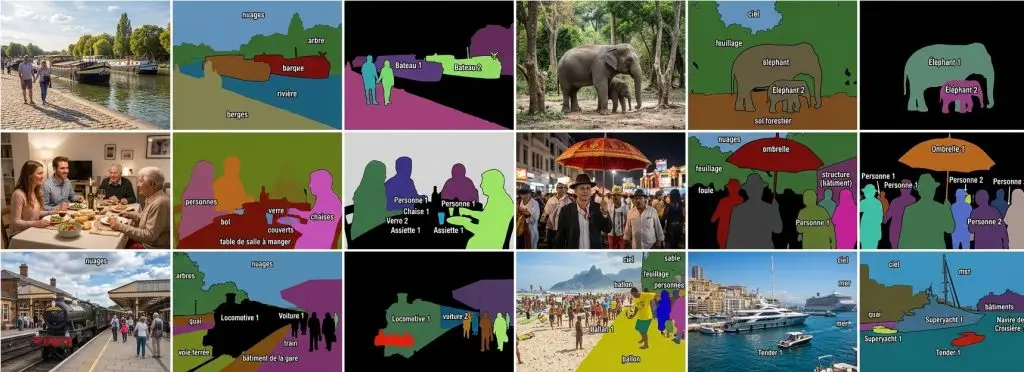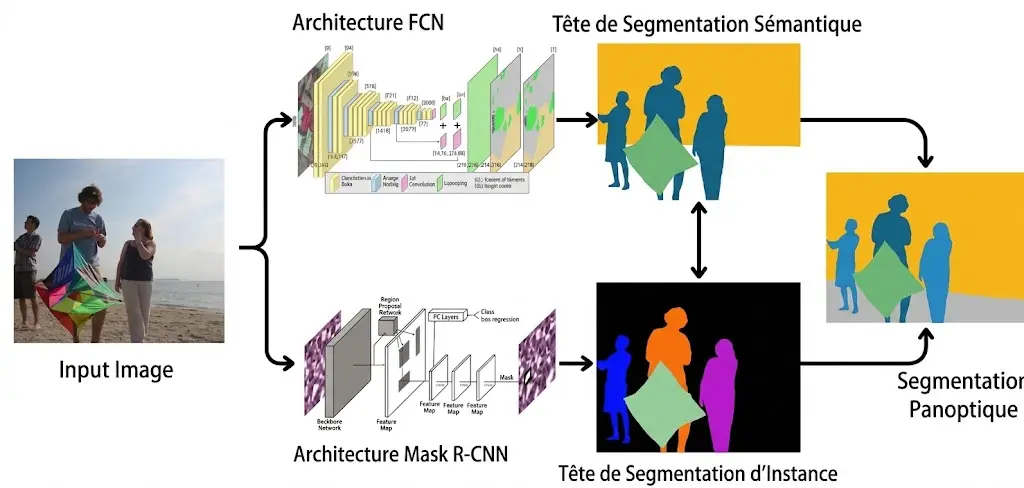
Le guide de la segmentation d’images a introduit la segmentation panoptique comme la forme qui combine sémantique et instances dans un seul livrable, et l’article consacré au choix entre ces deux dernières a montré qu’elle répond aux projets où les deux besoins coexistent réellement, plutôt qu’à un excès de prudence. Cet article détaille ce que cette combinaison implique techniquement : la règle qui tranche les pixels disputés entre les deux formes, ce qui change dans le travail d’annotation, et la métrique qui permet d’en mesurer la qualité.
La segmentation panoptique n’est pas une troisième technique indépendante des deux premières. C’est une contrainte de cohérence ajoutée à leur juxtaposition, et cette contrainte est ce qui la rend plus difficile à produire et à contrôler que la simple addition des deux formes qu’elle réunit. Le reste de cet article suit cette contrainte à travers ses conséquences concrètes : la règle qui l’applique pixel par pixel, ce qu’elle impose à l’ordre de travail, la métrique qui la mesure et le poste de coût qu’elle ajoute.
Ce que la segmentation panoptique ajoute à un projet de segmentation d’images
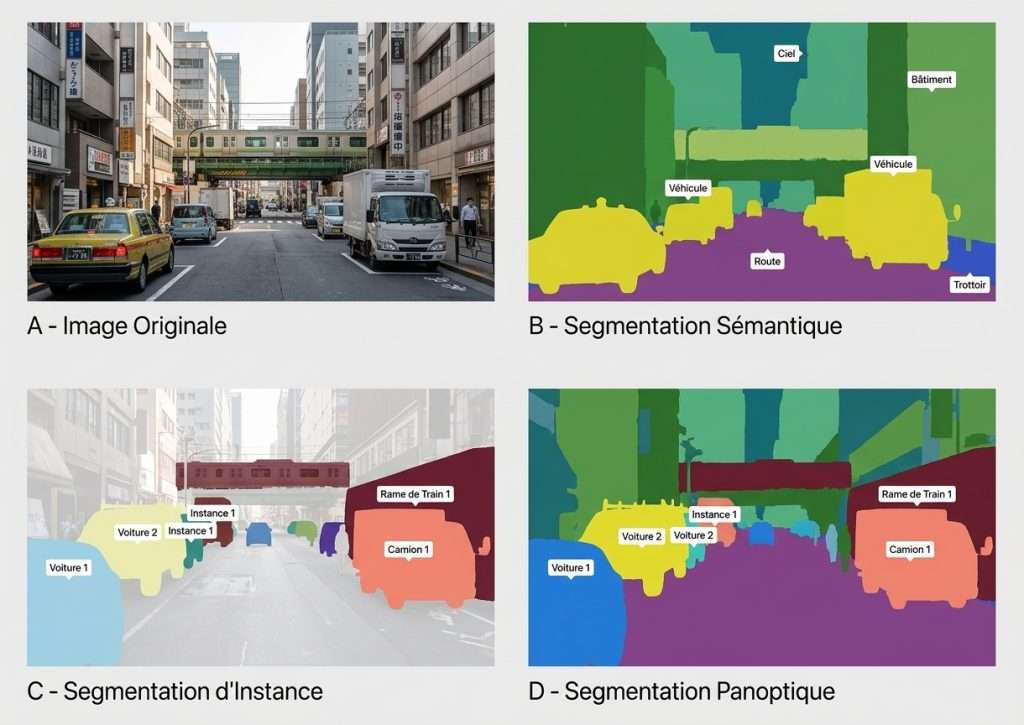
Dans une segmentation panoptique, chaque pixel reçoit une classe, et chaque pixel dont la classe est dénombrable reçoit en plus un identifiant d’instance. Un pixel de route porte uniquement sa classe. Un pixel de véhicule porte sa classe et le numéro du véhicule auquel il appartient, de sorte que deux véhicules voisins restent distinguables même s’ils partagent la même classe et se touchent. Cette double exigence repose sur une distinction que la littérature nomme « stuff » et « things ». Les classes de type stuff, région, végétation, ciel, sol, ne reçoivent jamais d’identifiant d’instance, parce qu’elles n’ont pas de contour individuel qui justifierait un compte. Les classes de type things, véhicule, personne, animal, en reçoivent toujours un, parce qu’elles décrivent des objets dénombrables par nature. Cette partition des classes se décide une fois, au cadrage, et s’applique ensuite à toute la production sans exception. Une conséquence pratique s’ensuit. La nomenclature d’un projet de segmentation panoptique ne se limite pas à une liste de classes : elle attribue à chacune un statut, stuff ou things, avant la première image annotée d’un projet de segmentation d’images de ce type. Une classe qui hésite entre les deux statuts, comme un tas de matériau parfois compté par unités et parfois traité comme une masse continue, doit être tranchée explicitement, faute de quoi deux annotateurs la traiteront différemment sur le même corpus.La règle de résolution des chevauchements
Une contrainte technique découle directement de la coexistence des deux formes : un même pixel ne peut appartenir qu’à une seule instance, alors que deux masques produits séparément, l’un sémantique et l’un d’instances, peuvent se chevaucher sur les mêmes pixels sans qu’aucune des deux couches ne le sache. La convention retenue par la quasi-totalité des projets de segmentation panoptique consiste à donner priorité à l’instance. Quand un pixel appartient à la fois à une région sémantique et à un objet dénombrable, l’appartenance à l’instance l’emporte, et la région sémantique environnante se referme autour du contour de l’objet plutôt que de le recouvrir. Un tronc d’arbre partiellement occulté par un piéton, par exemple, cède au piéton les pixels qu’il partage avec lui. Cette règle a une conséquence directe pour l’annotation qui n’existe dans aucune des deux formes prises séparément : l’ordre dans lequel les objets sont annotés devient significatif. Un opérateur qui trace d’abord la région sémantique puis les instances par-dessus obtient un résultat cohérent ; un opérateur qui superpose les deux couches sans règle de priorité produit des pixels à double appartenance que l’export panoptique doit ensuite arbitrer silencieusement, souvent de façon non documentée. Une observation importante en découle pour un projet de segmentation d’images qui prévoit une combinaison panoptique. Le guide d’annotation doit écrire cette règle de priorité aussi explicitement que la convention de frontière que le guide général a établie pour les pixels ambigus, parce qu’elle produit exactement le même type d’erreur silencieuse si elle reste implicite.Ce que la segmentation panoptique change pour un projet de segmentation d’images
Trois différences distinguent le travail d’annotation panoptique du simple cumul d’un passage sémantique et d’un passage instances sur les mêmes images. L’identifiant d’instance devient global à l’image entière plutôt que local à une classe. Dans une segmentation d’instances seule, deux objets de classes différentes peuvent recevoir un numéro d’instance qui se chevauche sans conséquence, parce que chaque classe se traite indépendamment. En panoptique, l’export final attribue un identifiant unique à travers toutes les classes de type things d’une même image, ce qui impose une étape de renumérotation que ni la production sémantique ni la production d’instances seule ne connaissent. La classe résiduelle change de statut. Dans une segmentation sémantique seule, une classe « autre » absorbe ce qui n’entre dans aucune catégorie utile, comme le guide général l’a signalé. En panoptique, cette classe résiduelle doit elle-même recevoir un statut stuff ou things, et le choix a un effet démesuré : la classer en things impose de dénombrer des objets que personne n’a l’intention de compter, la classer en stuff empêche tout comptage d’un objet qui aurait dû être identifié individuellement mais que la nomenclature n’a pas prévu. Le contrôle qualité se dédouble structurellement. Il faut vérifier séparément la cohérence sémantique, la cohérence des instances, et la cohérence de leur superposition selon la règle de priorité, ce qui correspond à trois passes plutôt que deux, alors même que le volume de pixels à vérifier n’a pas augmenté. Une conséquence pratique en résulte. Un projet qui aborde la segmentation panoptique comme une simple addition de deux protocoles déjà maîtrisés sous-estime systématiquement le temps de contrôle, parce que la troisième vérification, celle de la cohérence entre les deux couches, n’a d’équivalent dans aucune des deux formes simples.Mesurer une segmentation panoptique : la métrique de qualité panoptique
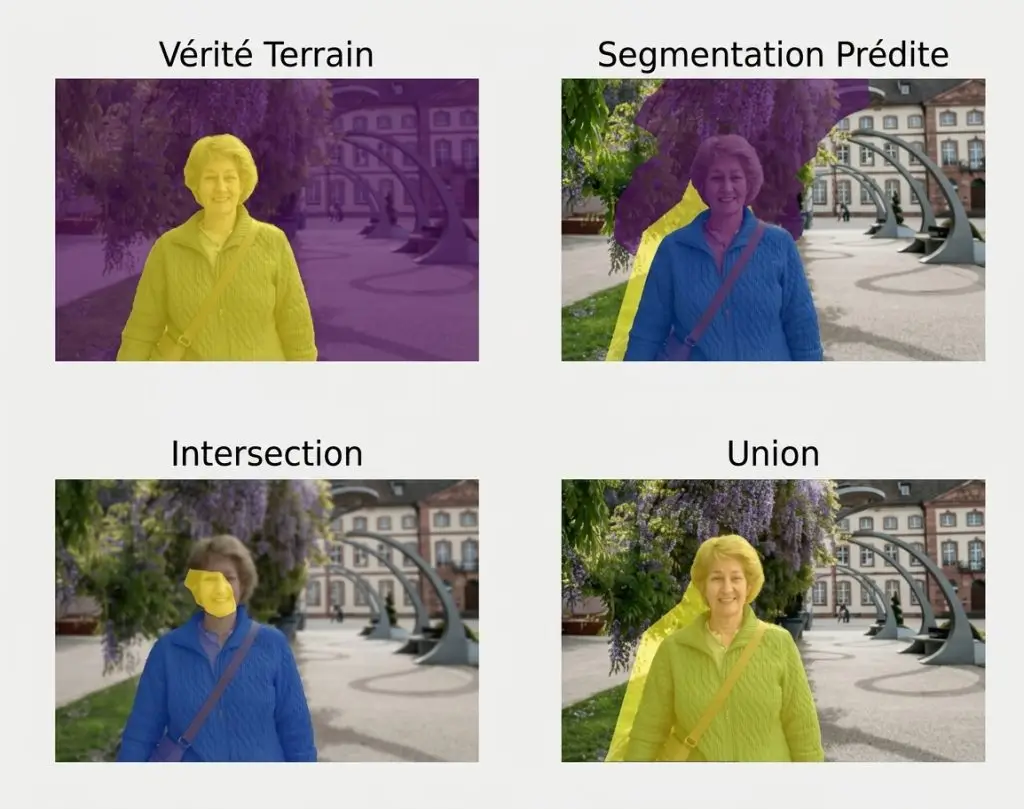
Les métriques usuelles de la segmentation d’images ne suffisent pas à évaluer un résultat panoptique, parce qu’aucune d’elles ne combine la fidélité du contour et la justesse de la détection dans un seul score comparable entre projets. La métrique de qualité panoptique répond à ce besoin en deux temps. Elle commence par apparier chaque segment prédit à un segment de référence quand leur recouvrement dépasse un seuil usuel de la moitié de leur surface commune ; en dessous de ce seuil, le segment est considéré comme manqué ou comme excédentaire plutôt qu’apparié. Sur les segments effectivement appariés, elle calcule ensuite deux composantes distinctes : une composante de fidélité, qui moyenne le recouvrement de chaque paire appariée, et une composante de détection, qui pénalise à la fois les segments manqués et les segments produits en trop. Le score final est le produit de ces deux composantes. Cette construction en produit a une propriété qui mérite d’être soulignée : un projet peut afficher un excellent recouvrement sur les objets qu’il détecte correctement tout en obtenant un score global médiocre parce qu’il en manque une part importante, ou l’inverse, détecter presque tous les objets avec des contours imprécis. Le score seul ne dit pas laquelle des deux composantes est en cause, ce qui impose de les lire séparément plutôt que de se fier au seul chiffre agrégé. Une observation mérite d’être ajoutée, qui rejoint un constat déjà posé ailleurs dans cette série : cette métrique se calcule par classe avant de se moyenner sur l’ensemble du corpus, et le score moyen masque exactement ce que la série a montré pour d’autres indicateurs globaux, à savoir qu’une classe rare et difficile peut afficher un score très bas sans influencer visiblement la moyenne dominée par les classes fréquentes. Lire le score par classe plutôt que le seul score global reste, ici comme ailleurs, le seul moyen de voir où se concentre l’échec réel d’un projet de segmentation d’images. Une dernière précision distingue cette métrique des indicateurs déjà rencontrés dans le guide général. Une variante existe qui ignore la classe pour ne considérer que la géométrie des segments, utile quand on cherche à évaluer la seule capacité à séparer des objets sans se prononcer sur leur identification, mais cette variante ne remplace jamais la métrique complète pour un livrable destiné à la production : elle sert de diagnostic complémentaire, pas de critère d’acceptation.Le coût réel d’une segmentation panoptique dans un projet de segmentation d’images
Les six postes de coût qu’un projet de segmentation d’images engage en général s’appliquent à la panoptique, mais leur addition ne suffit pas à en estimer le prix, parce qu’un poste supplémentaire s’ajoute et qu’il ne figure dans aucune des deux formes simples. Ce poste supplémentaire est le coût de cohérence : le temps que prennent la rédaction de la règle de priorité, sa vérification systématique sur les zones de contact entre stuff et things, et la renumérotation globale des identifiants d’instance en fin de production. Ce coût ne varie pas linéairement avec le volume d’images comme le font les postes d’annotation elle-même ; il dépend surtout de la fréquence des contacts entre régions et objets, ce qui le rend difficile à provisionner sans un pilote dédié. Une conséquence commerciale en découle. Chiffrer une segmentation panoptique comme la somme du prix d’une segmentation sémantique et du prix d’une segmentation d’instances sous-estime systématiquement le devis, dans une proportion qui dépend de la densité de contacts entre les deux types de classes et qui ne se révèle qu’au pilote.Formats d’export d’une segmentation d’images panoptique
Une segmentation panoptique se livre rarement sous la forme d’un seul masque coloré comme le ferait une segmentation sémantique isolée, parce qu’un même fichier doit porter à la fois la classe de chaque pixel et l’identifiant d’instance qui lui est associé quand elle en a un. Le format devenu standard pour ce type de livrable combine deux éléments complémentaires. Une image matricielle encode, par sa couleur ou sa valeur de pixel, l’identifiant de segment auquel chaque pixel appartient, sans distinguer à ce stade s’il s’agit d’une classe stuff ou d’une instance things. Un fichier structuré associé fait ensuite correspondre chaque identifiant de segment à sa classe et, le cas échéant, à son numéro d’instance, dans une table qui se lit indépendamment de l’image elle-même. Cette séparation entre l’image et la table de correspondance a une conséquence directe sur la production d’un projet de segmentation d’images de forme panoptique : la table doit rester strictement synchronisée avec l’image à chaque étape de correction, parce qu’une reprise qui modifie un contour sans mettre à jour la table produit un livrable dont l’image et les métadonnées se contredisent silencieusement. Aucun contrôle visuel du seul masque ne révèle ce type d’incohérence, puisque l’image reste correcte en apparence. Une observation importante en découle. Le choix de l’outil d’annotation doit intégrer cette contrainte de synchronisation dès le cadrage plutôt que la découvrir à l’export : un outil qui gère la couche sémantique et la couche instances comme deux exports indépendants imposera une étape de fusion manuelle où ce type d’erreur silencieuse se produit le plus souvent.Les projets multi-caméras : une cohérence à porter au-delà d’une seule image
Certains projets de segmentation d’images ajoutent une dimension que la panoptique, telle que décrite jusqu’ici, ne couvre pas par construction : plusieurs caméras synchronisées observent la même scène, et un objet visible sur deux caméras doit porter le même identifiant d’instance sur chacune d’elles, pas seulement un identifiant cohérent à l’intérieur de chaque image prise séparément. Un projet de suivi d’objets en environnement industriel équipé de quatre caméras grand angle illustre cette exigence : un même engin visible simultanément sur deux flux vidéo doit recevoir le même identifiant sur les deux, sous peine de compter deux fois le même objet dans les statistiques dérivées. La contrainte de cohérence des identifiants, déjà présente à l’intérieur d’une seule image panoptique, se reproduit alors à l’échelle du dispositif entier, avec une difficulté supplémentaire : les angles de vue différents rendent le même objet visuellement distinct d’une caméra à l’autre, ce qui complique la vérification humaine de la cohérence. Une conséquence pratique en résulte pour tout projet de segmentation d’images combinant plusieurs points de vue synchronisés. La règle de priorité entre stuff et things décrite plus haut ne suffit plus seule : elle doit être complétée par une convention de correspondance d’identifiants entre caméras, documentée et vérifiée avec la même rigueur, faute de quoi la panoptique, cohérente sur chaque image prise isolément, cesse de l’être au niveau du système complet.Ce que la segmentation panoptique ne résout pas
Combiner les deux formes ne dispense d’aucune des décisions que chacune impose séparément, et trois limites méritent d’être posées avant d’engager un projet sur cette base. La panoptique ne remplace pas la convention de frontière. Un pixel ambigu entre deux classes reste ambigu qu’il appartienne à une région stuff ou à un objet things, et la question posée par le guide général sur le sort de ces pixels se pose deux fois plutôt qu’une, une fois pour chaque couche. La panoptique ne se justifie pas par défaut. Comme l’article précédent l’a établi, un projet qui n’a besoin que de compter des objets ou que de mesurer une proportion de surface paie, en choisissant la panoptique par prudence, une cohérence entre deux couches dont aucune des deux ne sera exploitée séparément par le modèle final. La panoptique ne garantit pas une meilleure qualité globale que les deux formes prises séparément. Elle garantit une cohérence entre elles, ce qui est différent : un projet peut produire une segmentation panoptique parfaitement cohérente et néanmoins médiocre sur chacune de ses deux composantes si le guide d’annotation qui les régit séparément reste insuffisant. La panoptique n’élimine pas non plus la nécessité de documenter les cas d’occlusion propres aux instances. Un objet dénombrable partiellement caché derrière un autre pose exactement la même question de reconstitution que dans une segmentation d’instances isolée, la couche stuff environnante ne fournissant aucune information supplémentaire pour la trancher. Une conséquence pratique en résulte. La question à se poser avant d’engager un projet de segmentation d’images sous forme panoptique n’est pas si elle est possible, elle l’est presque toujours techniquement, mais si le modèle final exploite réellement les deux informations séparément. Dans le cas contraire, le coût de cohérence est payé pour rien.Les signaux d’une panoptique demandée par excès de prudence
Certains signes, visibles à la lecture d’un cahier des charges, indiquent qu’une demande de segmentation panoptique n’a pas été confrontée à l’usage réel du modèle. Le cahier des charges décrit un seul usage en aval, comptage ou mesure de surface, alors qu’il demande une segmentation panoptique complète. Un usage unique n’a besoin que d’une seule des deux couches. Le cahier des charges ne mentionne aucune classe de type stuff, ou à l’inverse aucune classe de type things. Une segmentation panoptique sur une nomenclature entièrement dénombrable ou entièrement amorphe n’apporte rien qu’une segmentation d’instances seule ou qu’une segmentation sémantique seule n’apporterait déjà. Le budget proposé ne distingue pas le coût de cohérence des deux couches prises séparément. Cette absence annonce presque toujours une sous-estimation qui se révélera au pilote plutôt qu’au cadrage. Le cahier des charges mentionne des caméras multiples ou des flux synchronisés sans évoquer la correspondance d’identifiants entre vues. Ce silence indique que la dimension multi-caméras, quand elle existe, n’a pas encore été chiffrée séparément de la panoptique elle-même. Une conséquence pratique s’ensuit. Ces signaux se lisent en quelques minutes et appellent tous la même question, celle que l’article précédent a déjà posée pour le choix entre sémantique et instances : que doit produire le modèle en sortie, et les deux couches lui servent-elles réellement toutes les deux.Erreurs fréquentes en segmentation panoptique
- Demander une segmentation panoptique sans vérifier que les deux couches serviront réellement au modèle.
- Laisser une classe résiduelle sans statut stuff ou things défini.
- Superposer les couches sémantique et instances sans règle de priorité écrite.
- Annoter les objets dans un ordre qui n’applique pas la règle de priorité retenue.
- Chiffrer le projet comme la simple somme des deux formes séparées.
- Contrôler la cohérence entre couches en fin de production plutôt qu’en continu.
- Se fier au seul score de qualité panoptique global sans lecture par classe.
- Oublier la renumérotation globale des identifiants d’instance à l’export.
- Confondre un score bas de fidélité de contour avec un score bas de détection.
- Reproduire la nomenclature d’un projet sémantique ou d’instances sans revoir le statut de chaque classe.