Un chiffre unique de recouvrement dit qu’un corpus s’écarte d’une référence, sans dire où ni pourquoi. Or les trois défauts qu’il agrège appellent des corrections distinctes, et les distinguer coûte moins cher que de traiter le corpus en bloc.
Cet article expose ce dispositif. Il prolonge l’article consacré au coût de la segmentation d’images.
Ce que les métriques de recouvrement mesurent
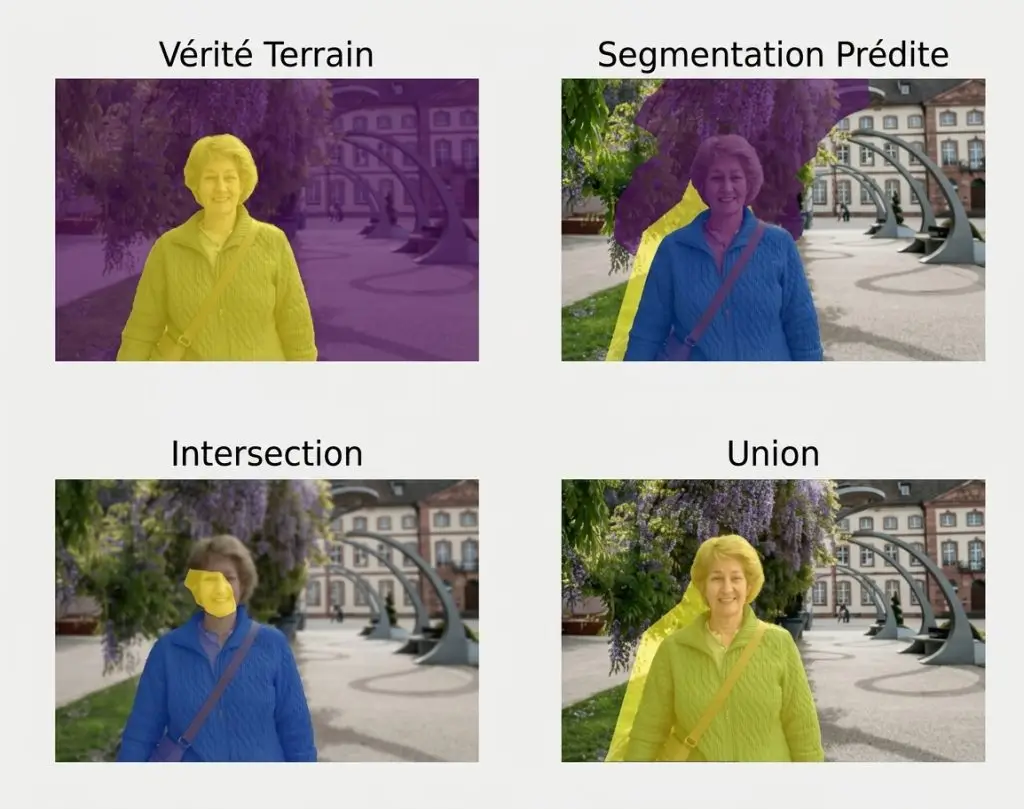
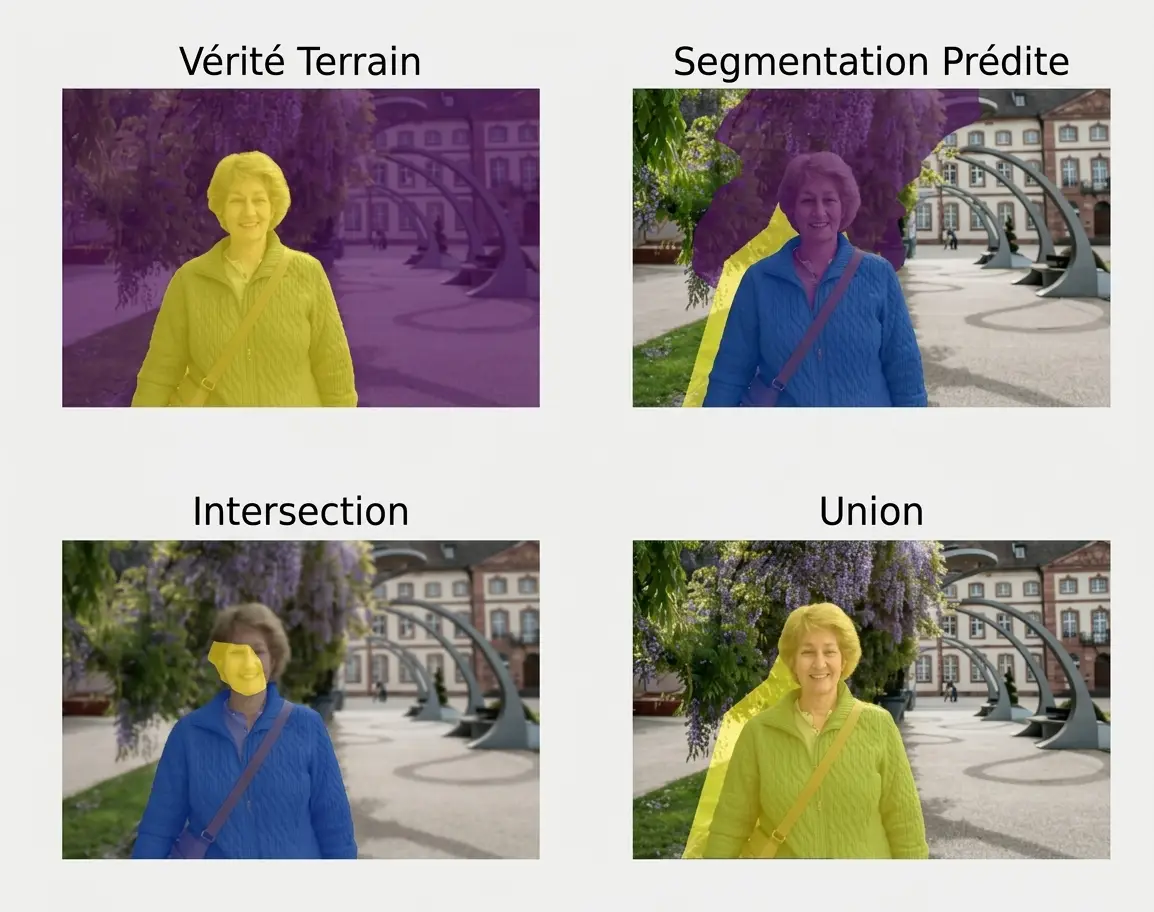
Deux indicateurs dominent la segmentation d’images. Ils expriment la même idée. Ils rapportent la surface commune à deux annotations à la surface qu’elles couvrent ensemble. Trois propriétés en découlent en segmentation d’images. La valeur croît lorsque les deux régions coïncident et décroît sinon. Elle ne dit pas si l’écart vient d’un décalage, d’une omission ou d’une confusion. Et elle dépend fortement de la taille de la région, un écart de contour identique pesant davantage sur un petit objet. Une conséquence pratique importante en découle. La troisième propriété rend une moyenne sur des régions de tailles inégales difficile à interpréter en segmentation d’images, les petites régions y pesant peu alors qu’elles concentrent souvent l’enjeu.Les trois défauts que le recouvrement agrège
Une valeur basse peut provenir de causes sans rapport entre elles. Trois familles se distinguent. Le décalage de frontière, où la région est correctement identifiée et mal délimitée. L’omission ou l’ajout, où une région entière manque ou n’existe pas. Et la confusion de classe, où la région est correctement tracée et mal étiquetée. Une observation importante en découle. Ces trois familles appellent des corrections différentes, une convention de placement pour la première, un renforcement du contrôle pour la deuxième et une clarification de nomenclature pour la troisième, ce qui rend leur agrégation coûteuse.Ce que la taille des régions fausse
Un effet mérite d’être isolé car il produit des chiffres trompeurs. Quatre conséquences en découlent en segmentation d’images. Une moyenne par pixel est dominée par les grandes régions. Une moyenne par région donne le même poids à un objet minuscule et à une surface entière. Une classe rare et petite peut être totalement manquée sans que la valeur globale bouge. Et deux corpus de même valeur globale peuvent présenter des comportements opposés sur les petits objets. Une conséquence pratique s’ensuit. Ces quatre effets imposent de rapporter les valeurs par classe et par tranche de taille, un chiffre unique masquant précisément ce qui intéresse la plupart des usages.Mesurer là où se situe l’enjeu
Une méthode restreint la mesure à ce qui compte en segmentation d’images. Le principe consiste à ne calculer l’accord que dans une bande autour des frontières. Trois bénéfices en découlent pour un projet de segmentation d’images. Les intérieurs de région, où personne ne se trompe, cessent de gonfler la valeur. L’indicateur devient sensible aux écarts qui font l’objet du travail. Et la comparaison entre annotateurs devient enfin représentative de leur désaccord réel. Une observation importante en découle pour un projet de segmentation d’images. Cette restriction change complètement l’échelle des valeurs obtenues, ce qui impose de déclarer la largeur de bande employée sous peine de rendre deux mesures incomparables.Ce que la distance de frontière apporte
Un indicateur complémentaire mesure une grandeur différente. Il exprime l’écart entre deux contours en unités de longueur plutôt qu’en surface. Trois avantages l’accompagnent. Il ne dépend pas de la taille de la région. Il s’exprime dans la même unité que la tolérance de contour, ce qui rend la comparaison directe. Et sa valeur maximale localise le pire écart au lieu de le moyenner avec les autres. Une conséquence pratique importante en découle. Le deuxième avantage en fait l’indicateur naturel d’un projet ayant fixé une tolérance chiffrée, la conformité se vérifiant alors directement au lieu de passer par une conversion approximative.Ce que le désaccord entre annotateurs borne
Une mesure précède toute exigence et elle est souvent omise. Deux annotateurs formés traitant les mêmes images obtiennent des résultats différents. Trois conséquences en découlent en segmentation d’images. Aucun corpus ne peut être plus cohérent que ce désaccord ne le permet. Une exigence supérieure à cette valeur est intenable par construction. Et une performance annoncée n’a de sens que rapportée à ce plafond. Une observation importante en découle. Cette mesure se conduit sur quelques images en une journée, et son absence conduit à négocier une exigence sans savoir si quelqu’un peut l’atteindre.Séparer les trois familles
Une opération transforme un chiffre en diagnostic et elle se programme. Trois calculs distincts remplacent la moyenne unique en segmentation d’images. Le taux de régions présentes dans une annotation et absentes de l’autre, qui isole les omissions et les ajouts. Le taux de régions correctement localisées mais mal étiquetées, qui isole les confusions de classe. Et l’écart de contour sur les seules régions à la fois correctement identifiées et étiquetées, qui isole le décalage. Une conséquence pratique importante en découle. Ces trois calculs s’exécutent sur les mêmes données que la moyenne unique, ils ne demandent aucune mesure supplémentaire, et ils indiquent laquelle des trois corrections engager.Ce que le contrôle automatique détecte
Six vérifications de segmentation d’images s’exécutent sans référence externe. Les pixels restés sans classe dans un corpus qui se veut exhaustif. Les régions de quelques pixels seulement, signature caractéristique d’échardes. Les trous non déclarés situés à l’intérieur des régions annotées. Les recouvrements entre régions dans une formulation qui les interdit. Les proportions de classe aberrantes par rapport à la distribution habituelle du corpus. Et les distributions de surface décalées entre annotateurs, révélatrices d’un biais systématique de placement. Une conséquence pratique s’ensuit pour un projet de segmentation d’images. La dernière vérification est la plus efficace et la moins pratiquée, un biais systématique se détectant sur une distribution alors qu’il reste invisible région par région.Ce que le contrôle automatique ne voit pas
Quatre défauts de segmentation d’images échappent à toute vérification programmée. L’omission d’une région, qui ne produit aucune anomalie formelle. La confusion systématique entre deux classes, cohérente et donc plausible. Le contour suivant le contraste plutôt que la convention. Et la mauvaise application d’une règle par un annotateur qui l’avait mal comprise. Une observation en découle. Ces quatre défauts demandent un contrôle humain, ce qui fait de l’automatique et de l’humain deux dispositifs complémentaires plutôt que substituables.Comment échantillonner
Quatre principes gouvernent l’échantillonnage de contrôle d’un corpus de segmentation d’images. Cibler les classes à forte variabilité plutôt que tirer uniformément. Inclure les images aux contours découpés, où se concentre le désaccord. Retenir les configurations difficiles identifiées au lot pilote. Et conserver un échantillon constant d’un lot à l’autre, seul moyen de mesurer une dérive. Une conséquence pratique en découle. Le premier principe est le plus efficace, un échantillon uniforme étant dominé par les régions faciles alors que l’essentiel du désaccord se situe sur quelques classes.Formuler une exigence tenable
Une méthode en quatre temps évite un engagement irréalisable. Mesurer le désaccord entre annotateurs sur les classes visées. Séparer l’exigence par classe, une frontière nette et une transition douce n’appelant pas la même valeur. Exprimer la tolérance en unités de longueur plutôt qu’en recouvrement, ce qui la rend indépendante de la taille. Et distinguer les familles de défaut entre elles, l’omission et le décalage n’ayant pas du tout les mêmes conséquences. Une observation importante en découle. La troisième étape est la plus utile et la moins pratiquée, une tolérance en pixels se vérifiant directement là qu’un seuil de recouvrement dépend de la taille des régions mesurées.Ce que le rapport doit contenir
Six éléments composent un rapport de contrôle utile en segmentation d’images. La méthode d’échantillonnage et la largeur de bande employée. Les valeurs par classe plutôt qu’une moyenne unique. La répartition des écarts entre les trois familles de défaut. Le désaccord mesuré entre annotateurs, qui situe la performance. L’évolution des indicateurs d’un lot au suivant. Et la liste des configurations pour lesquelles aucune convention stable n’a pu être arrêtée. Une conséquence pratique s’ensuit pour un projet de segmentation d’images. Le troisième élément est le plus rare et le plus utile, il transforme un constat en diagnostic et oriente la correction vers la convention, le contrôle ou la nomenclature selon la famille dominante.Aborder le contrôle d’un corpus
Cinq questions cadrent le contrôle d’un corpus de segmentation d’images. Le désaccord entre annotateurs a-t-il été mesuré. Sa valeur borne toute exigence. La mesure porte-t-elle sur une bande autour des frontières. Son absence gonfle artificiellement les valeurs. Les valeurs sont-elles rapportées par classe. Une moyenne unique masque les classes difficiles. Les familles de défaut sont-elles distinguées. Leur agrégation empêche le diagnostic. Et un échantillon constant est-il conservé entre les lots. Son absence rend la dérive indétectable. Ces cinq réponses déterminent le dispositif et son coût. Les poser avant la production évite de constater après coup un défaut que les premiers lots contenaient déjà.Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen. Un indicateur unique décrit sans diagnostiquer. Trois constats la composent. Le recouvrement agrège trois familles de défaut qui appellent des corrections distinctes. Sa valeur dépend de la taille des régions, ce qui rend une moyenne difficile à interpréter et impose de rapporter par classe. Et la distance de frontière s’exprime dans l’unité de la tolérance, ce qui en fait l’indicateur naturel d’une exigence chiffrée. Ce constat prolonge les chapitres précédents, la frontière restant le lieu où la qualité se joue et où elle doit se mesurer.Les erreurs les plus fréquentes
- Rapporter une moyenne unique pour tout un corpus.
- Calculer l’accord sur toute la surface plutôt qu’aux frontières.
- Ne pas déclarer la largeur de bande employée.
- Agréger décalage, omission et confusion dans un même chiffre.
- Fixer une exigence sans avoir mesuré le désaccord entre annotateurs.
- Exprimer une tolérance en recouvrement plutôt qu’en longueur.
- Échantillonner uniformément plutôt que par classe difficile.
- Négliger le suivi des distributions de surface entre annotateurs.
- Attendre du contrôle automatique qu’il détecte les omissions.
- Comparer deux valeurs obtenues avec des méthodes de calcul différentes.