Deux corpus au même format ne sont pas nécessairement comparables. Ce qui rend une annotation exploitable ne tient pas au conteneur qui la porte mais aux informations que ce conteneur ne prévoit pas, et que personne ne pense à joindre.
Cet article expose ces questions. Il prolonge l’article consacré à la qualité en segmentation d’images.
Les trois familles de représentation
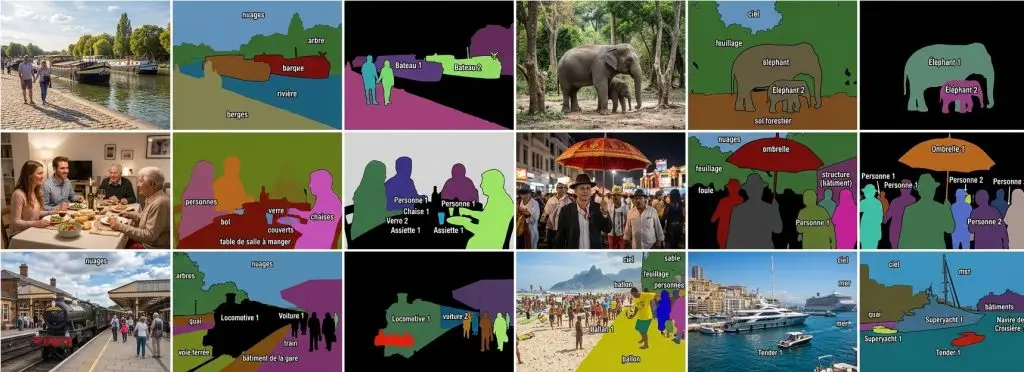
Trois façons de porter une région coexistent en segmentation d’images. Le masque matriciel, une image où chaque pixel porte un identifiant. Le contour vectoriel, une suite de sommets décrivant une frontière. Et le codage compact, qui décrit les régions sans stocker chaque pixel individuellement. Une conséquence pratique importante en découle. Ces trois familles ne portent pas la même information, la conversion du vectoriel vers le matriciel étant immédiate alors que l’inverse reste approximative.Ce que le masque permet et coûte
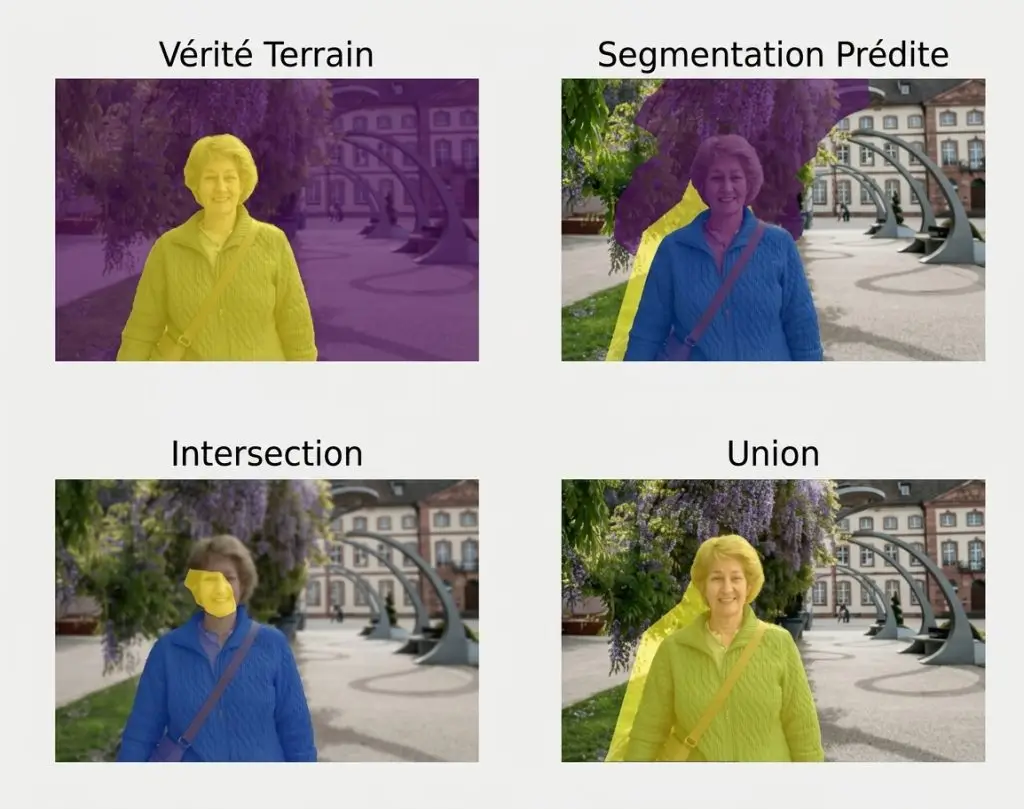
Quatre propriétés caractérisent ce format de segmentation d’images. Il représente n’importe quelle forme, y compris ajourée ou multiplement connexe. Il se compare directement, deux masques se superposant pixel à pixel. Il se corrige localement mais lourdement, une retouche demandant de rééditer l’image. Et il fige la résolution, un masque ne se régénérant pas à une autre finesse. Une observation importante en découle. La dernière propriété est la plus contraignante à long terme, un corpus livré uniquement en masque ne pouvant servir un usage exigeant une résolution supérieure.Ce que le vectoriel permet et coûte
Quatre propriétés le distinguent du masque. Il se modifie facilement, un sommet se déplaçant sans reprendre le tracé. Il se régénère à toute résolution, ce qui préserve les usages futurs. Il est compact, quelques dizaines de valeurs décrivant une région. Et il représente mal les formes ajourées, un feuillage demandant alors un contour impraticable. Une conséquence pratique s’ensuit pour un projet de segmentation d’images. Ces quatre propriétés conduisent à une recommandation simple, conserver le vectoriel lorsqu’il existe et livrer le masque, ce qui préserve la modifiabilité sans compliquer l’exploitation.Ce que les formats ne portent pas
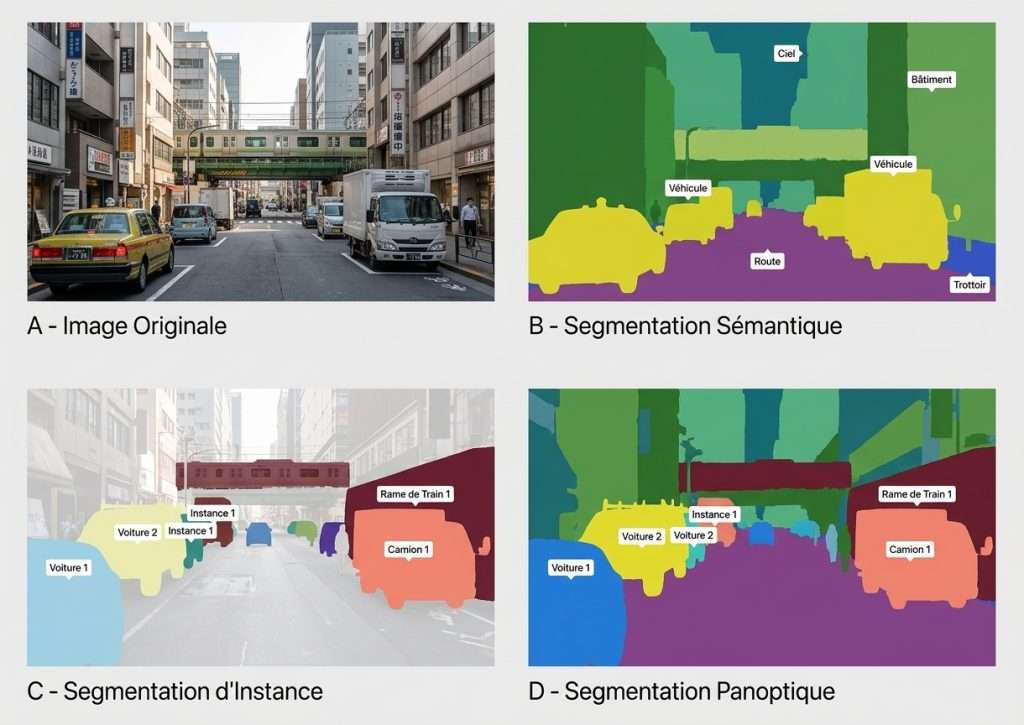
Six informations conditionnent l’exploitation d’un corpus de segmentation d’images. Elles n’appartiennent à aucun format. La formulation employée, sémantique, instances ou panoptique. La règle de placement du contour dans les transitions incertaines. La tolérance de contour retenue. Le seuil de taille en dessous duquel une région n’a pas été annotée. La distinction entre classe fourre-tout et zone non annotée. Et la méthode de production, manuelle ou assistée, avec l’outil employé. Une observation importante en découle. Ces six informations déterminent la comparabilité de deux corpus de segmentation d’images, et leur absence explique la majorité des difficultés rencontrées lors d’une fusion.Les pertes à la conversion
Quatre opérations dégradent silencieusement une annotation. Le rééchantillonnage, qui décale les frontières sans le signaler. La conversion du vectoriel vers le masque, qui fige la finesse. La conversion du masque vers le vectoriel, qui invente un contour lisse là où le masque était irrégulier. Et la fusion de classes, qui supprime définitivement une distinction que rien ne permettra de rétablir. Une conséquence pratique importante en découle. La première opération est la plus fréquente et la plus dommageable, un masque redimensionné indépendamment de son image introduisant un décalage que personne ne remarque avant l’entraînement.Les identifiants de classe
Cette difficulté banale et coûteuse mérite d’être exposée. Un masque porte des nombres, pas des noms de classe. Trois conséquences en découlent pour un projet de segmentation d’images. La table de correspondance doit accompagner le corpus, faute de quoi les valeurs ne signifient rien. Deux corpus du même domaine emploient rarement les mêmes identifiants. Et une fusion sans vérification produit une confusion parfaitement silencieuse entre classes. Une observation en découle. La troisième conséquence est la plus insidieuse, deux corpus fusionnés avec des tables différentes produisant un corpus cohérent en apparence et faux en profondeur.Le fichier d’accompagnement
Une solution simple traite ce que les formats ne portent pas. Un document joint au corpus consigne les conventions que la géométrie n’exprime pas. Quatre propriétés le rendent utile en segmentation d’images. Il est lisible sans outil particulier, ce qui garantit qu’il survivra aux changements de plateforme. Il tient sur une page, ce qui rend sa rédaction praticable et sa lecture probable. Il accompagne chaque livraison plutôt que le seul premier lot, les conventions évoluant. Et il porte une date, ce qui permet de rattacher chaque lot à la version de convention qui l’a produit. Une conséquence pratique importante en découle. La dernière propriété résout un problème fréquent, un corpus constitué sur plusieurs mois portant des règles différentes selon les lots sans que rien ne le signale.Ce que l’outil doit permettre
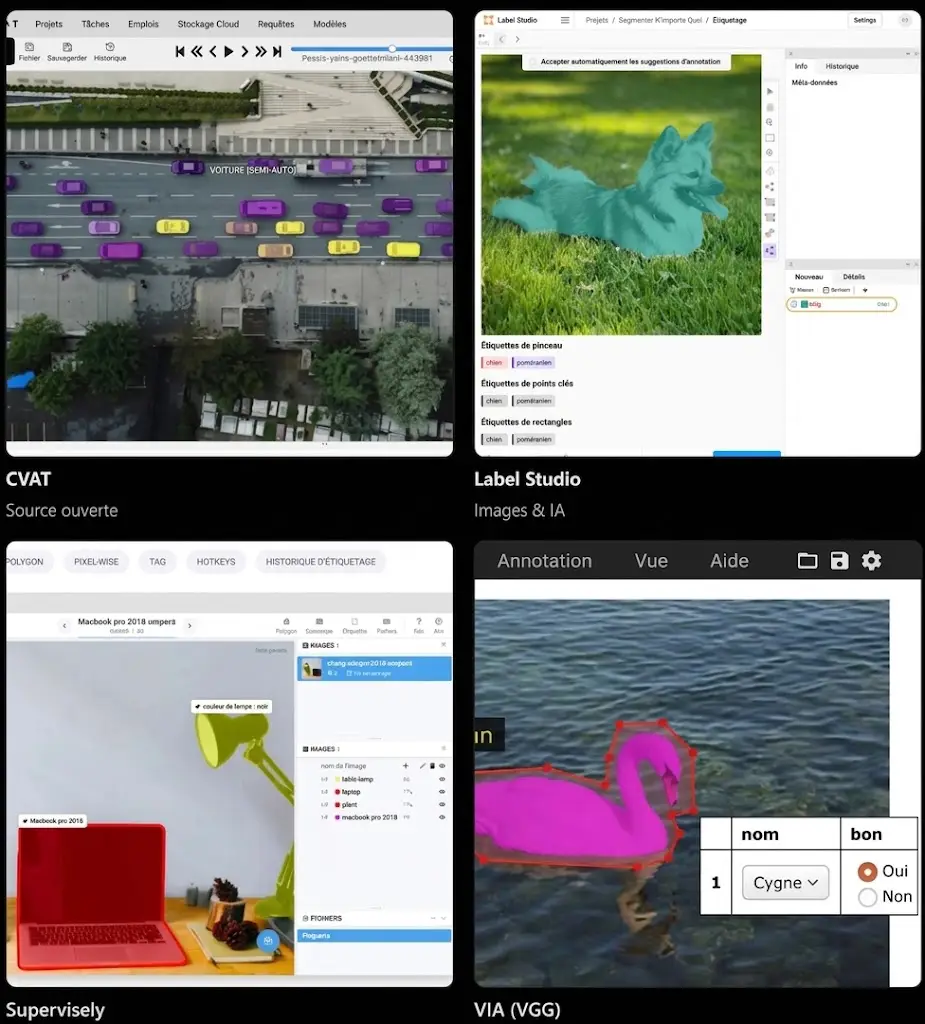
Six fonctions d’outillage conditionnent la production en segmentation d’images. Les quatre méthodes de tracé, polygone, pinceau, sélection et désignation assistée. Le réglage fin de la largeur de pinceau, jusqu’au pixel. Le masquage temporaire des classes déjà tracées. L’affichage du contour en superposition plutôt qu’en aplat opaque. La conversion entre polygone et masque en cours de travail. Et l’export préservant les informations de convention que le format ne prévoit pas. Une conséquence pratique s’ensuit. La dernière fonction est la plus rare, la plupart des plateformes exportant une géométrie correcte et perdant les conventions qui la rendent interprétable.Ce que l’outil doit permettre à une équipe
Cinq fonctions concernent l’organisation d’une équipe de segmentation d’images. Elles portent sur l’organisation plutôt que sur le geste. L’affectation d’images à des annotateurs avec suivi d’avancement. Le circuit de validation, qui distingue un lot annoté d’un lot vérifié. La gestion des versions, sans laquelle une correction écrase l’état antérieur. Les journaux d’activité, seule source de cadence réelle. Et la gestion des droits, qui restreint l’accès aux données les plus sensibles. Une observation en découle pour un projet de segmentation d’images. La quatrième fonction est la plus sous-estimée, les journaux fournissant les données qui alimentent tout chiffrage ultérieur et ne se reconstituant pas après coup.Auto-hébergé ou hébergé
Quatre critères tranchent cette question en segmentation d’images. Le lieu de traitement, exigence dirimante sur les données médicales ou industrielles sensibles. La charge d’exploitation, que l’auto-hébergement transfère au client ou au prestataire. La maîtrise des accès, chaque consultation étant journalisée sur une infrastructure contrôlée. Et l’indépendance vis-à-vis d’un fournisseur, un changement de tarification n’affectant alors pas un projet en cours. Une conséquence pratique s’ensuit. Le premier critère est souvent le seul qui compte, une exigence contractuelle sur le lieu de traitement écartant d’emblée les plateformes qui ne l’offrent pas.Évaluer un outil avant de s’engager
Cinq épreuves suffisent. Elles occupent une journée. Charger une image réelle du projet plutôt qu’un exemple de démonstration. Tracer une région ajourée au pinceau et vérifier le réglage de largeur. Poser une région assistée et examiner sa conformité à la convention plutôt que sa netteté. Exporter et relire le fichier en cherchant les six informations exposées plus haut. Et faire manipuler l’outil par un annotateur pendant une session de travail complète. Une observation importante en découle. La quatrième épreuve écarte le plus de candidats, une plateforme confortable à l’usage produisant fréquemment un export dépouillé des conventions du projet.Migrer d’un outil à un autre
Quatre difficultés accompagnent un changement en cours de projet. La conversion des annotations existantes, dont les identifiants et les conventions doivent être remappés. La perte des historiques, journaux et versions ne migrant généralement pas. La reprise de la formation, les raccourcis et les réflexes étant spécifiques. Et la cohabitation temporaire, deux outils produisant en parallèle des exports à harmoniser. Une conséquence pratique s’ensuit pour un projet de segmentation d’images. La quatrième difficulté produit un défaut durable, un corpus dont une part provient d’un outil et le reste d’un autre présentant une différence de régularité de contour que rien ne signale.Aborder le choix d’un format et d’un outil
Cinq questions cadrent ce choix en segmentation d’images. Les données peuvent-elles quitter l’infrastructure du client. Cette réponse tranche l’hébergement. Le corpus contient-il des formes ajourées. Leur présence impose le masque et un pinceau fin. Le corpus sera-t-il corrigé ou étendu. Cette réponse plaide pour conserver le vectoriel. L’export porte-t-il les conventions. Son absence rend le corpus difficilement réutilisable. Et une fusion avec un corpus existant est-elle prévue. Elle impose de vérifier les tables de classes. Ces cinq réponses déterminent le choix et ses conséquences. Les poser avant de commencer évite un corpus techniquement conforme et pratiquement inexploitable.Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen. Le format porte la géométrie et pas ce qui la rend interprétable. Trois constats la composent. Six informations déterminent la comparabilité de deux corpus et n’appartiennent à aucun format. Le rééchantillonnage décale les frontières sans le signaler, ce qui en fait la dégradation la plus discrète. Et deux corpus fusionnés avec des tables de classes différentes paraissent cohérents et sont faux. Ce constat prolonge le chapitre précédent, une mesure supposant une comparabilité que le format seul ne garantit pas.Les erreurs les plus fréquentes
- Livrer un masque sans la table de correspondance des classes.
- Redimensionner un masque indépendamment de son image.
- Convertir un masque en vectoriel et croire retrouver un contour d’origine.
- Supprimer la représentation vectorielle après export du masque.
- Fusionner deux corpus sans vérifier les identifiants de classe.
- Choisir un outil sans avoir relu son export.
- Négliger les journaux d’activité comme source de cadence.
- Omettre de déclarer la formulation et la règle de placement.
- Confondre classe fourre-tout et zone non annotée dans le format.
- Mélanger deux outils dans un même corpus sans le signaler.