Les articles précédents ont posé les méthodes. Celui-ci examine ce qu’aucune méthode ne résout entièrement : les configurations où l’information n’est pas dans les images et où la convention remplace l’observation.
Il prolonge l’article consacré au contrôle qualité en annotation vidéo.
Les trois familles de difficultés
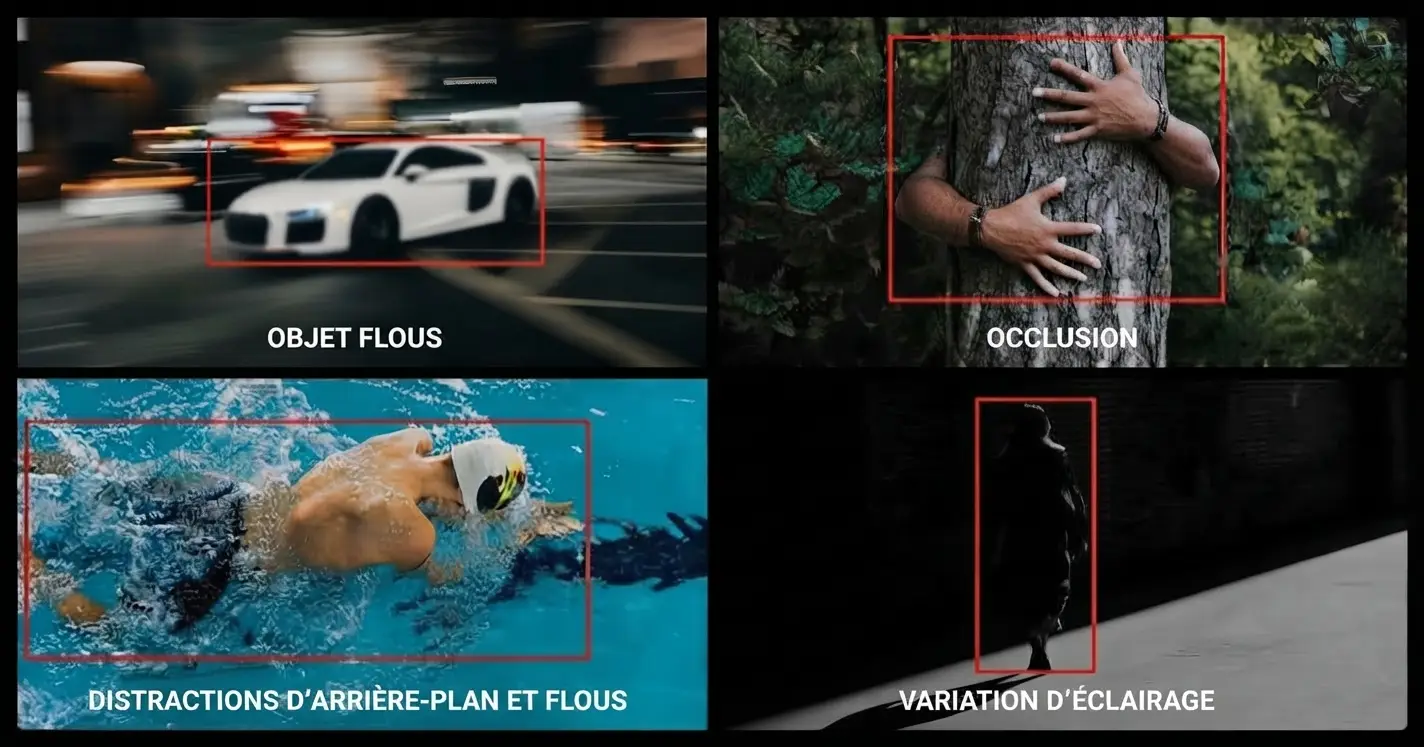
Trois causes distinctes produisent les défaillances de l’annotation vidéo. L’occlusion, où l’objet est présent et masqué par autre chose. La dégradation d’image, où l’objet est visible et mal résolu, flou de mouvement et compression notamment. Et l’ambiguïté d’identité, où l’objet est parfaitement visible et indiscernable d’un autre. Une conséquence pratique importante en découle. Ces trois familles appellent des réponses différentes, la première une convention, la deuxième un choix d’acquisition et la troisième un renoncement documenté, ce qui rend leur confusion coûteuse en annotation vidéo.Les degrés d’occlusion
Quatre situations se distinguent. Elles n’appellent pas le même traitement. L’occlusion partielle légère, où l’objet reste identifiable et localisable avec une marge d’erreur. L’occlusion partielle forte, où seule une fraction reste visible et où la localisation devient une estimation. L’occlusion totale brève, où l’objet disparaît quelques images et où la continuité rend le rattachement évident. Et l’occlusion totale prolongée, où le rattachement repose sur une inférence plutôt que sur une observation. Une observation importante en découle. Seule la quatrième situation est réellement indécidable, les trois premières relevant d’une convention à écrire plutôt que d’une limite de la donnée.Annoter un objet partiellement masqué
Trois conventions d’annotation vidéo coexistent. Leur choix change le corpus. Annoter la partie visible seule, ce qui produit une boîte fidèle à l’observation et une taille qui varie avec le masquage. Annoter l’emprise complète estimée, ce qui produit une taille stable et une part d’invention. Et annoter les deux, une boîte visible et une boîte estimée, ce qui double le travail et lève l’ambiguïté. Une conséquence pratique s’ensuit pour un projet d’annotation vidéo. La première convention produit une variation de taille que les contrôles automatiques signalent comme suspecte, ce qui impose d’accompagner ce choix d’un attribut d’occlusion afin que le contrôle distingue un masquage d’une erreur.Le flou de mouvement
Cette dégradation est spécifique à l’annotation vidéo. Elle est souvent traitée à tort comme un défaut. Un objet en déplacement rapide s’étale sur plusieurs pixels pendant la durée d’exposition. Trois conséquences en découlent. Le contour devient indéterminé, ce qui rend une délimitation précise impossible et un désaccord entre annotateurs inévitable. La position elle-même devient ambiguë, l’objet occupant une traînée plutôt qu’un point. Et l’apparence change, une texture floue ne ressemblant plus à la même texture nette. Une observation importante en découle. Ces images seront présentes en production, ce qui interdit de les écarter du corpus, et la convention doit préciser où placer la boîte sur une traînée, au début, au centre ou à la fin.La ré-identification après occlusion
Cette opération concentre la difficulté du suivi. Elle repose sur trois indices. La continuité de trajectoire, un objet réapparaissant là où son mouvement le prédisait. La similarité d’apparence, couleur et forme rapprochant deux observations. Et le contexte, un objet réapparaissant dans une configuration cohérente avec ce qui l’entoure. Trois situations affaiblissent ces indices. La durée, une longue occlusion rendant la prédiction de trajectoire imprécise. Le changement d’apparence, un objet réapparaissant sous un autre angle ou un autre éclairement. Et la présence d’objets similaires, qui multiplie les candidats compatibles. Une conséquence pratique importante en découle pour un projet d’annotation vidéo. Ces trois affaiblissements se cumulent dans les scènes denses, ce qui rend la ré-identification la plus difficile exactement là où elle serait la plus utile.Ce que la compression détruit
Cette dégradation invisible mérite d’être exposée. Elle affecte les petits objets d’un corpus d’annotation vidéo. La compression vidéo réduit le volume en supprimant de l’information jugée peu perceptible. Quatre effets mesurables en découlent. Les petits objets perdent leur texture et deviennent des taches de couleur. Les contours produisent des artefacts en blocs, ce qui déplace la frontière apparente. Les images intermédiaires portent moins d’information que les images clés, ce qui rend la qualité variable au sein d’une même séquence. Et le mouvement rapide déclenche une compression plus agressive, ce qui dégrade précisément les moments difficiles. Une observation en découle. Le dernier effet est le plus pénalisant et le moins connu, la compression et le flou de mouvement se cumulant sur les mêmes images, ce qui produit une dégradation bien supérieure à ce que chacun produirait seul.Ce que la convention doit prévoir
Six décisions de convention couvrent l’essentiel de ces difficultés. Elles s’écrivent avant la production. Le seuil de visibilité au delà duquel un objet cesse d’être annoté. Le traitement d’une occlusion, interruption, suspension ou interpolation à travers. La durée au delà de laquelle un rattachement n’est plus tenté. La position de la boîte sur un objet flou. La conduite à tenir lorsque deux candidats sont également plausibles. Et l’attribut permettant de marquer une décision incertaine. Une conséquence pratique en découle pour un projet d’annotation vidéo. La cinquième décision est la plus souvent omise et la plus déterminante, l’absence de règle conduisant chaque annotateur à trancher selon son intuition et produisant une incohérence qu’aucun contrôle ne rattrape.Les objets à la limite de résolution
Une quatrième difficulté accompagne les trois précédentes et elle est purement quantitative. Un objet lointain occupe trop peu de pixels pour être qualifié de façon fiable. Quatre conséquences en découlent. La classe devient incertaine, une silhouette de quelques pixels pouvant appartenir à plusieurs catégories. La délimitation varie fortement entre annotateurs, un pixel d’écart représentant une part importante de l’objet. La détection elle-même devient inconstante, un même objet apparaissant et disparaissant selon le contraste local. Et le coût par objet augmente alors que sa valeur pour l’entraînement diminue. Une conséquence pratique importante en découle pour un projet d’annotation vidéo. Ces quatre conséquences justifient de fixer une taille minimale en dessous de laquelle un objet n’est pas annoté, seuil chiffré qui économise du travail et supprime une source majeure d’incohérence.La classe des cas indécidables
Cette catégorie doit exister dans toute nomenclature d’annotation vidéo. Son absence produit un dommage silencieux. Certaines configurations ne portent pas l’information nécessaire à une décision. Trois bénéfices accompagnent cette classe en annotation vidéo. Elle évite un choix arbitraire, qui introduit du bruit dans le corpus sans que rien ne le signale. Elle mesure la part réellement indécidable, information qui borne la performance atteignable. Et elle localise les configurations à traiter, chaque cas marqué pointant une convention manquante ou une limite de la donnée. Une observation importante en découle. Un taux anormalement bas sur cette classe indique que les annotateurs ont cessé de l’utiliser plutôt qu’une amélioration, ce qui en fait un indicateur à interpréter dans les deux sens.Ce que l’acquisition peut corriger
Quatre décisions amont réduisent ces difficultés. Elles échappent à l’annotation elle-même. La durée d’exposition, dont la réduction diminue le flou au prix d’une image plus sombre. La cadence de capture, une cadence supérieure réduisant le déplacement entre deux images et facilitant l’appariement. Le débit de compression, dont l’augmentation préserve les petits objets au prix du volume. Et le placement de la caméra, un angle plus élevé réduisant les occlusions mutuelles entre objets. Une conséquence pratique s’ensuit. La dernière décision est la plus efficace et la moins coûteuse, un changement d’angle supprimant une part des occlusions plutôt que de les rendre plus lisibles, ce qui la place avant toute considération de traitement.Ce que l’assistance ne résout pas
Trois limites bornent l’apport des modèles d’assistance sur ces configurations. Un modèle propose un rattachement plausible sans disposer de plus d’information qu’un annotateur, ce qui produit une décision confiante et non fondée. Le biais de validation joue plus fortement ici qu’ailleurs, une proposition sur un cas difficile étant précisément celle qu’il faudrait examiner. Et une erreur sur ces configurations se propage, une permutation à une occlusion contaminant tout ce qui suit. Une observation importante en découle pour un projet d’annotation vidéo. Ces trois limites conduisent à une règle simple, l’assistance traite les segments faciles et l’humain traite les occlusions et les croisements, répartition qui concentre l’effort là où l’automatique échoue.Mesurer ce qui est indécidable
Une opération quantifie cette part et elle borne toute exigence contractuelle. Deux annotateurs traitent une séquence contenant des occlusions et leurs rattachements se comparent. Trois informations exploitables en découlent. Le taux d’accord sur les rattachements après occlusion, généralement inférieur à l’accord sur les détections. La durée d’occlusion au delà de laquelle cet accord s’effondre, qui fournit le seuil de rattachement à retenir. Et la liste des cas de désaccord, matière première du référentiel. Une conséquence pratique importante en découle. La deuxième information transforme un seuil arbitraire en valeur mesurée, opération qui occupe quelques heures et qui remplace une convention discutable par un constat.Aborder ces difficultés dans un projet
Cinq questions cadrent ces difficultés d’annotation vidéo. Elles se posent avant la production. Quelle proportion de la durée présente des occlusions. Cette réponse dimensionne la difficulté principale. Le flou de mouvement est-il présent aux vitesses de travail. Cette réponse impose une convention de placement. Les objets sont-ils visuellement distinguables entre eux. Une réponse négative rend la ré-identification structurellement limitée. La caméra peut-elle être repositionnée. Cette réponse ouvre la correction la plus efficace. Et une classe indécidable est-elle prévue. Son absence transforme une limite en bruit. Ces cinq réponses déterminent les conventions à écrire et l’exigence tenable. Les poser avant de commencer évite un engagement sur une continuité que la donnée ne porte pas.Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen. Ces difficultés se répartissent en trois catégories dont une seule relève de l’annotation. Trois constats la composent. Une part relève de l’acquisition, flou, compression et angle de caméra se corrigeant en amont ou pas du tout. Une part relève de la convention, occlusions et seuils demandant une règle écrite plutôt qu’un effort supplémentaire. Et une part est irréductible, deux objets identiques en contact prolongé ne portant pas l’information qui les sépare. Ce constat rejoint celui que les séries précédentes ont établi dans d’autres domaines : distinguer une erreur d’une limite évite de consacrer un effort à corriger ce qui ne peut pas l’être, et cette distinction se pose au diagnostic plutôt qu’après plusieurs tentatives.Les erreurs les plus fréquentes
- Traiter le flou de mouvement comme un défaut et écarter les images concernées.
- Annoter la partie visible seule sans attribut d’occlusion associé.
- Ne pas fixer le seuil de durée au delà duquel un rattachement n’est plus tenté.
- Omettre la règle applicable lorsque deux candidats sont également plausibles.
- Négliger la classe des cas indécidables.
- Interpréter une baisse du taux d’indécidables comme un progrès.
- Attendre d’un modèle de suivi qu’il tranche une configuration indécidable.
- Ignorer le cumul entre compression et flou sur les images de mouvement rapide.
- Exiger une continuité d’identité que la durée d’occlusion rend impossible.
- Négliger le repositionnement de caméra, correction la plus efficace.