Un corpus vidéo ne se constitue pas en accumulant des heures de séquences. Ce qui détermine sa valeur est le nombre de situations distinctes qu’il couvre, et cette quantité n’a presque aucun rapport avec la durée totale.
Cet article expose la méthode. Il prolonge l’article consacré au RGPD et à l’annotation vidéo.
Pourquoi la durée trompe
Quatre propriétés distinguent un corpus d’annotation vidéo d’un corpus d’images. La redondance est extrême, deux images consécutives portant presque la même information. La diversité ne croît pas avec la durée, une heure sur une même scène apportant moins qu’une minute sur soixante scènes différentes. Le volume de stockage croît, lui, proportionnellement à la durée. Et le coût d’annotation suit le nombre d’objets plutôt que la durée. Une conséquence pratique importante en découle. Ces quatre propriétés font qu’un corpus de plusieurs centaines d’heures peut couvrir moins de situations qu’un corpus de quelques heures bien choisies, ce qui déplace l’enjeu d’un projet d’annotation vidéo de la collecte vers la sélection.Les dimensions à couvrir
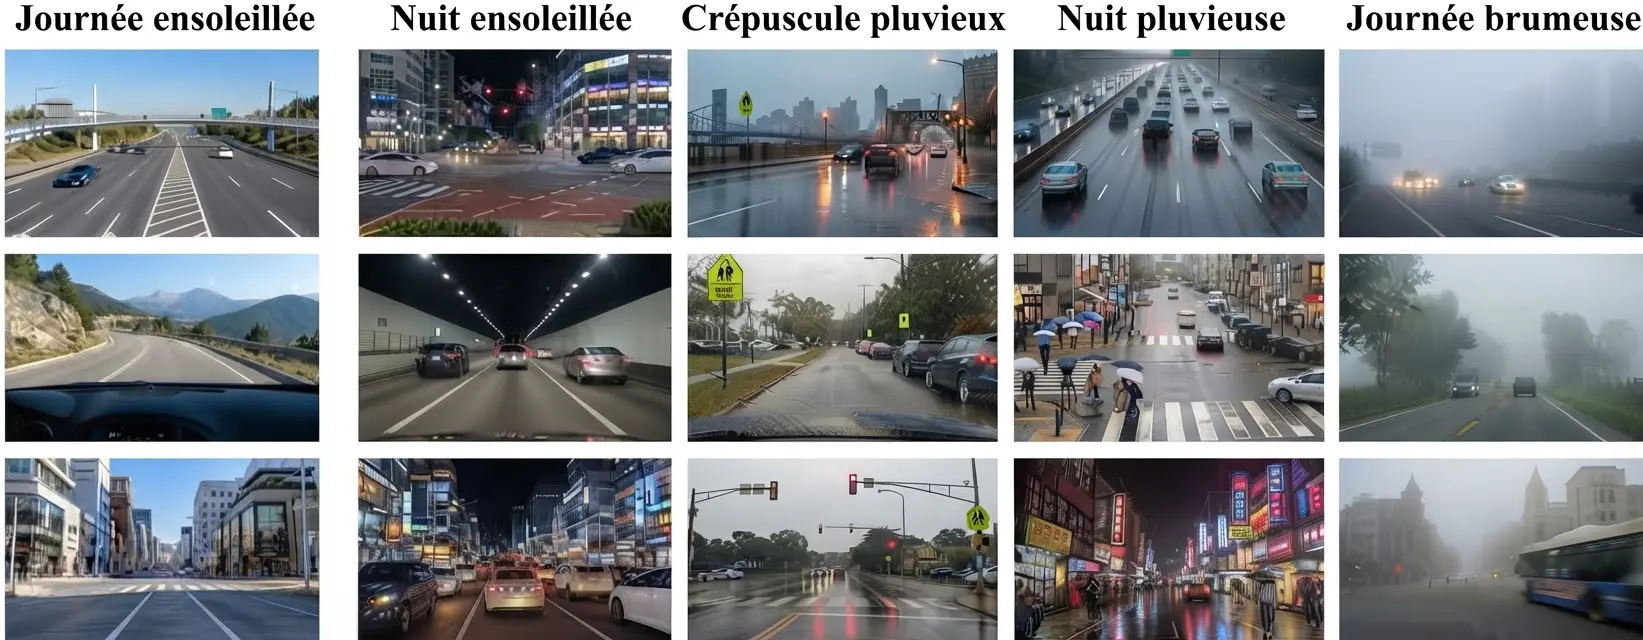
Six axes définissent la couverture d’un corpus d’annotation vidéo. Ils se multiplient entre eux. Les conditions d’éclairement, du plein jour à la nuit en passant par les transitions. La météo, dont les effets diffèrent selon le capteur. Les configurations de scène, densité, agencement et type de lieu. Les classes d’objets, y compris celles qui sont rares. Les comportements et dynamiques, un objet immobile et un objet rapide n’étant pas le même problème. Et les conditions techniques, matériel, cadence et compression. Une observation importante en découle. Ces six axes se multiplient plutôt qu’ils ne s’additionnent, ce qui explique qu’un corpus paraissant volumineux couvre en réalité une fraction des combinaisons, et rend le comptage des contextes plus informatif que celui des heures.Sélectionner plutôt que collecter
Quatre stratégies de sélection s’appliquent. Leur efficacité diffère nettement. Le tirage aléatoire, qui reflète la distribution réelle et sur-représente le banal. La sélection par événement, qui retient les séquences contenant ce qui intéresse. La sélection par incertitude, qui retient ce qu’un modèle existant ne maîtrise pas. Et la sélection par couverture, qui complète les combinaisons manquantes du plan. Une conséquence pratique s’ensuit pour un projet d’annotation vidéo. Ces quatre stratégies se combinent plutôt qu’elles ne se remplacent, la première fournissant une base représentative et les trois autres l’enrichissant sur ce qui compte.Le découpage en séquences
Cette décision structure le corpus. Elle est rarement examinée en annotation vidéo. Une vidéo continue doit être découpée en unités exploitables. Quatre critères orientent ce découpage en annotation vidéo. La durée, une séquence trop longue empêchant le travail parallèle et une séquence trop courte fragmentant les pistes. Les frontières naturelles, changements de plan ou d’action fournissant des points de coupe sans conséquence. L’homogénéité de conditions, une séquence traversant une transition jour et nuit mélangeant deux contextes. Et l’autonomie de compréhension, une séquence devant contenir assez de contexte pour être annotable seule. Une observation importante en découle. Le deuxième critère est le plus efficace et le moins appliqué, couper à un changement de plan supprimant par construction le problème des pistes traversant une frontière de tâche.La séparation entraînement et évaluation
Une règle gouverne cette séparation. Son non-respect produit des chiffres flatteurs et faux. Deux images de la même séquence partagent trop de contexte pour se répartir de part et d’autre. Quatre niveaux de séparation existent et leur exigence croît. Par image, inaccessible en vidéo puisque des images voisines sont presque identiques. Par séquence, minimum acceptable et encore insuffisant lorsque plusieurs séquences proviennent de la même scène. Par scène ou par site, correct pour la plupart des usages. Et par campagne ou par période, le plus exigeant, qui mesure ce que le système fera sur des données nouvelles. Une conséquence pratique importante en découle. Le premier niveau est encore pratiqué et il produit une performance qui n’a aucun sens, deux images voisines réparties entre entraînement et évaluation revenant à évaluer sur des données d’entraînement.Les métadonnées à enregistrer
Six informations conditionnent l’exploitation du corpus. Elles coûtent quelques champs à la saisie. La date et l’heure, qui permettent de reconstituer les conditions. Le site ou la caméra, indispensable à une séparation correcte. Les paramètres d’acquisition, matériel, cadence, résolution et compression. Les conditions observées, météo et éclairement. La référence à la séquence source et la position temporelle dans celle-ci. Et le traitement subi, anonymisation et extraction notamment. Une observation en découle pour un projet d’annotation vidéo. La deuxième métadonnée est celle dont l’absence est la plus dommageable, sans identifiant de site il devient impossible de garantir une séparation correcte, ce qui rend toute performance annoncée invérifiable.L’échantillonnage d’images
Une seconde décision de granularité accompagne le découpage en séquences. Toutes les images d’une séquence retenue ne sont pas nécessairement conservées. Trois régimes d’échantillonnage se rencontrent. La conservation intégrale, qui préserve la continuité et convient au suivi. L’échantillonnage régulier, qui réduit le volume et rompt la continuité au delà d’un certain pas. Et l’extraction ciblée, qui retient les images entourant un événement et jette le reste. Une conséquence pratique importante en découle pour un projet d’annotation vidéo. Le deuxième régime est incompatible avec le suivi d’identité au delà d’un pas modeste, ce qui impose de trancher entre la réduction de volume et la conservation de la continuité plutôt que d’espérer les deux.Le dimensionnement
Quatre facteurs déterminent le volume nécessaire, et ils ne se réduisent pas à une durée. Le nombre de contextes à couvrir, produit des six axes retenus. Le nombre d’objets par classe et par contexte, base réelle du dimensionnement. La variabilité interne de chaque classe, qui détermine combien d’exemples sont nécessaires. Et la difficulté de la tâche, une distinction fine exigeant plus d’exemples qu’une distinction évidente. Une conséquence pratique s’ensuit. Le volume se raisonne en objets par classe et par contexte plutôt qu’en heures, une heure de scène vide et une minute de scène dense ne comparant pas, ce qui rend le comptage sur un échantillon indispensable à tout dimensionnement sérieux.Les classes rares
Cette difficulté domine la constitution d’un corpus d’annotation vidéo. Elle se traite en amont. Un événement rare ne se rencontre pas par échantillonnage aléatoire. Trois méthodes permettent de les récupérer. La recherche dans les archives à partir de signalements, qui suppose un accès aux registres d’incidents. La sollicitation d’un modèle existant, dont les détections à faible score localisent des candidats. Et la mise en scène délibérée, praticable dans certains contextes industriels et impossible ailleurs. Une observation importante en découle. La disponibilité de ces trois méthodes conditionne la faisabilité du projet et elle se vérifie avant tout engagement, l’absence des trois signifiant que les exemples positifs ne seront pas réunis.La constitution progressive
Une organisation en lots vaut mieux qu’une acquisition massive et elle mérite d’être défendue. Un corpus construit d’un bloc fige des conventions avant qu’elles soient éprouvées. Quatre avantages accompagnent l’approche progressive en annotation vidéo. Les conventions se corrigent entre deux lots plutôt qu’après l’ensemble. La cadence et le coût se mesurent tôt et se projettent. Un premier modèle permet de pré-annoter les lots suivants. Et les lacunes révélées par ce modèle orientent le contenu du lot suivant. Une conséquence pratique en découle pour un projet d’annotation vidéo. Le quatrième avantage est le plus important, il transforme la constitution en boucle plutôt qu’en ligne droite et concentre l’effort sur ce qui manque réellement.Ce qu’il ne faut pas faire
Quatre pratiques dégradent un corpus d’annotation vidéo. Elles paraissent pourtant raisonnables. Écarter les séquences de mauvaise qualité, qui seront présentes en production. Sur-échantillonner une scène disponible plutôt que d’en chercher de nouvelles, ce qui gonfle le volume sans ajouter de diversité. Découper à intervalle fixe sans tenir compte des frontières naturelles. Et conserver uniquement les images annotées en supprimant la séquence source, ce qui interdit toute réexploitation. Une observation en découle. La deuxième pratique est la plus fréquente, une scène accessible produisant facilement des heures de contenu dont l’apport marginal décroît rapidement.Ce que la documentation doit contenir
Six éléments accompagnent une livraison d’annotation vidéo. Leur absence limite la réutilisation. Le plan d’échantillonnage effectivement réalisé. Le tableau des effectifs par classe et par contexte. Les conventions d’annotation, avec la cadence et la politique d’occlusion. Le critère de séparation retenu entre entraînement et évaluation. Le rapport de qualité. Et la liste des contextes non couverts, qui borne explicitement le domaine d’emploi. Une conséquence pratique importante en découle. Le dernier élément est le plus rare et le plus utile, déclarer ce que le corpus ne couvre pas transformant une limite invisible en limite connue.Aborder la constitution d’un corpus vidéo
Cinq questions cadrent cette phase d’un projet d’annotation vidéo. Elles se posent avant toute acquisition. Combien de contextes distincts le périmètre comporte-t-il. Ce produit détermine la couverture nécessaire. Les classes rares sont-elles accessibles. Leur absence rend le projet infaisable en l’état. Quel critère de séparation sera retenu. Cette réponse conditionne la validité de toute mesure. L’identifiant de site sera-t-il enregistré. Son absence interdit une séparation correcte. Et la constitution se fera-t-elle par lots. Une acquisition massive fige des conventions non éprouvées. Ces cinq réponses déterminent le volume et la validité du résultat. Les poser avant de collecter évite un corpus volumineux et pauvre en diversité.Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen. La valeur d’un corpus vidéo tient à sa diversité et non à sa quantité. Trois constats la composent. La redondance temporelle rend la durée sans rapport avec l’information contenue, propriété qui n’a pas d’équivalent en annotation d’images. La sélection pèse davantage sur la valeur que la production, ce qui déplace l’enjeu vers la conception. Et la séparation entre entraînement et évaluation exige un critère plus strict qu’en images, deux séquences d’une même scène partageant trop de contexte. Ce constat rejoint celui que les séries précédentes ont établi dans d’autres domaines : ce qui détermine la valeur d’un corpus est ce qu’il couvre délibérément, et cette couverture se conçoit avant l’acquisition plutôt qu’elle ne se constate après.Les erreurs les plus fréquentes
- Dimensionner un corpus en heures plutôt qu’en contextes et en objets.
- Sur-échantillonner une scène accessible au lieu d’en chercher de nouvelles.
- Séparer entraînement et évaluation par image plutôt que par scène.
- Omettre l’identifiant de site dans les métadonnées.
- Découper à intervalle fixe sans tenir compte des changements de plan.
- Écarter les séquences dégradées qui seront présentes en production.
- Supprimer la séquence source après extraction des images annotées.
- Attendre les classes rares au lieu de les rechercher délibérément.
- Acquérir massivement avant d’avoir éprouvé les conventions.
- Livrer sans la liste des contextes non couverts.