
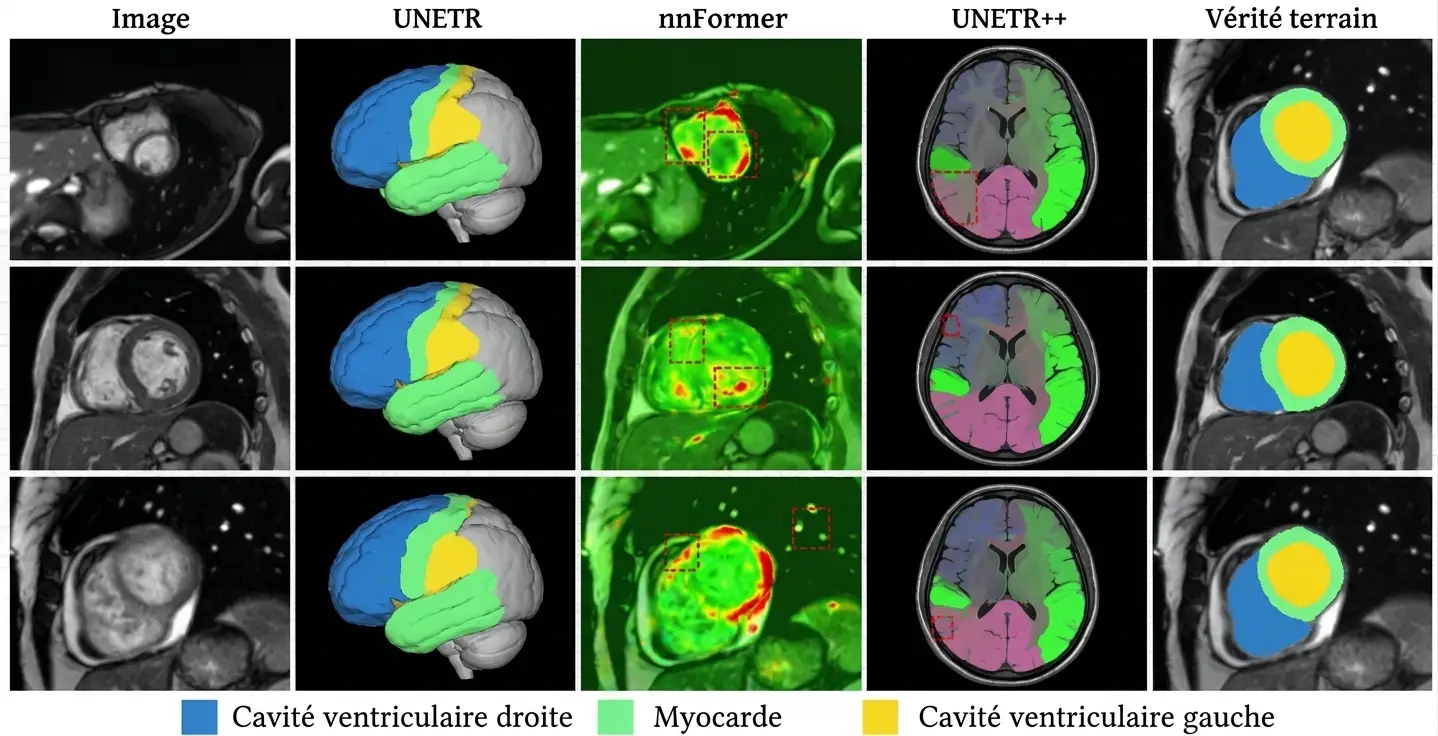
Une évaluation comparative récente sur la segmentation de tumeurs cérébrales résume la situation du domaine en une phrase. Ses auteurs constatent que plusieurs modèles de fondation atteignent des scores de Dice allant jusqu’à 0,894 lorsqu’on leur fournit des boîtes englobantes extrêmement précises, ce qui dépasse la performance de segmentation de l’architecture spécialisée de référence, mais que celle-ci demeure le réseau dominant en segmentation d’images médicales en raison du caractère impraticable de la fourniture d’invites aussi précises.
Autrement dit, le modèle généraliste bat le modèle spécialisé à condition qu’on lui indique très exactement où se trouve la structure. Or, si l’on sait déjà où elle se trouve avec cette précision, le problème est en grande partie résolu.
Cet article examine ce que les données disponibles disent réellement de cette transition et de ses conséquences pour la constitution des corpus. Il prolonge le guide complet de la segmentation d’images médicales et clôt cette série.
Deux paradigmes de segmentation d’images médicales
Les deux approches en présence ne diffèrent pas seulement par leur architecture mais par ce qu’elles supposent d’un projet. Le paradigme spécialisé consiste à entraîner un modèle sur la tâche précise visée, à partir d’un corpus annoté pour elle. Sa forme la plus aboutie est un cadre auto-configurant qui adapte automatiquement son architecture et ses paramètres aux caractéristiques des données. Il demande un corpus et produit un modèle qui ne fait qu’une chose, très bien. Le paradigme de fondation, à l’inverse, consiste à entraîner un modèle unique sur des corpus massifs et hétérogènes, puis à l’orienter vers une tâche par une invite, clic, boîte ou texte. Il ne demande pas de corpus spécifique et produit un modèle qui fait beaucoup de choses, moins bien. La question qui intéresse réellement un projet n’est pas lequel est supérieur dans l’absolu, mais lequel atteint l’objectif clinique pour le coût total le plus faible, corpus compris.Ce que disent les comparaisons de segmentation d’images médicales
Plusieurs évaluations de segmentation d’images médicales conduites dans des conditions comparables convergent, et leurs chiffres méritent d’être lus précisément. Une étude publiée en 2026 sur la segmentation de métastases osseuses au scanner, portant sur 88 patients et 11 006 paires image-étiquette annotées par des experts, rapporte des scores de Dice de 0,6280 pour un modèle de fondation médical, 0,4480 pour un modèle de fondation généraliste affiné, et 0,6849 pour le cadre spécialisé. Une seconde étude, portant sur la segmentation pelvienne en imagerie par résonance magnétique, observe que les modèles de fondation employés sans adaptation obtiennent des scores de Dice inférieurs de dix à vingt pour cent au cadre spécialisé sur les structures bien définies et convexes, et rencontrent de grandes difficultés sur les structures disjointes et bilatérales, pour lesquelles les scores tombent en dessous de 0,6. Ces résultats dessinent ensemble un profil cohérent. Sur une tâche définie, avec un corpus annoté, l’approche spécialisée reste devant. L’écart n’est pas immense et il est constant.Le paradoxe de l’invite
Le résultat cité en introduction mérite d’être développé car il est régulièrement mal interprété. Les modèles de fondation dépassent effectivement les modèles spécialisés lorsqu’on leur fournit une invite de très haute qualité. Mais cette invite encode précisément l’information qui fait la difficulté de la tâche : savoir où est la structure et quelle est son étendue approximative. Une évaluation de segmentation d’images médicales qui fournit des invites dérivées de la vérité terrain ne mesure donc pas ce qu’elle paraît mesurer. Elle mesure la capacité du modèle à raffiner une localisation déjà donnée, ce qui est utile mais différent d’une segmentation autonome. La conséquence pratique est double. Pour comparer honnêtement deux approches, l’invite doit provenir d’une source réaliste, humaine ou automatique, et non de la référence. Et pour un usage assisté, où un annotateur fournit l’invite, cette limitation n’en est pas une : le paradoxe disparaît dès lors qu’un humain est dans la boucle, ce qui explique que ces modèles soient bien plus convaincants en outil d’annotation qu’en système autonome.Là où les modèles de fondation gagnent
Un résultat exactement inverse mérite autant d’attention, car il désigne le point faible réel de l’approche spécialisée. Une étude sur l’adaptation d’un modèle de fondation à la segmentation volumique observe que, sur des données d’une provenance différente de celle de l’entraînement, le cadre spécialisé subit un échec complet en contexte zéro coup sur les images par résonance magnétique, n’obtenant qu’un score de Dice de 10,9 %, alors que le modèle adapté conserve une performance de 60,4 %. Dix pour cent contre soixante pour cent. L’écart est ici bien plus considérable que celui observé en conditions favorables, et il joue dans l’autre sens. Ce résultat est probablement le plus important de l’article pour un projet réel, parce que la situation qu’il décrit est fréquente. Un modèle entraîné sur les données d’un établissement rencontre en déploiement des images d’un autre appareil, d’un autre protocole d’acquisition ou d’une autre population. La robustesse au changement de domaine n’est pas une propriété accessoire, c’est souvent ce qui décide du succès d’un déploiement.La spécialisation referme l’écart
Un troisième résultat vient compléter le tableau et il est décisif pour la question qui nous occupe. La même étude sur la segmentation pelvienne observe qu’après affinage sur les données du projet, le modèle de fondation allégé atteint 0,864, au niveau du cadre spécialisé, sans différence significative sur la plupart des structures. Autrement dit, l’écart initial ne tient pas à une limite intrinsèque mais à l’absence de spécialisation. Et la spécialisation, quel que soit le paradigme, passe par des données annotées de la tâche visée. C’est précisément le point où l’analyse touche à la constitution des corpus. Le débat entre paradigmes ne porte pas sur la nécessité d’annoter mais sur la quantité nécessaire et sur ce qu’il faut annoter.Les modèles multi-organes déjà disponibles
Une évolution concrète mérite d’être distinguée du débat théorique, car elle produit dès aujourd’hui des effets mesurables : la disponibilité de modèles publics couvrant des dizaines de structures anatomiques. Ces modèles changent le point de départ d’un projet de segmentation d’images médicales portant sur des structures standard. Là où il fallait constituer un corpus initial, il devient possible de produire une pré-annotation complète et de concentrer l’effort humain sur la correction et sur les structures non couvertes. Trois réserves accompagnent ce constat et elles découlent de ce qui précède. Ces modèles héritent de la qualité de leurs corpus d’entraînement, et plusieurs travaux ont documenté des imperfections concentrées sur certaines structures. Leur couverture est très inégale selon la modalité, le scanner étant bien mieux servi que l’échographie ou la pathologie. Et leur performance sur les cas pathologiques est nettement inférieure à celle observée sur l’anatomie normale, alors que ce sont les cas pathologiques qui motivent la plupart des projets. La conséquence pratique est de les employer comme point de départ et jamais comme référence. Un projet qui accepte leurs sorties sans vérification importe leurs biais, et cette importation est d’autant plus difficile à détecter qu’elle est uniforme.Ce qui change pour l’annotation
Trois déplacements se dessinent pour l’annotation en segmentation d’images médicales, et les nier serait aussi peu sérieux que de les exagérer.Le volume baisse sur les tâches courantes
C’est le déplacement le plus visible et le plus souvent commenté. Pour une structure bien couverte par les modèles disponibles, organe compact et contrasté, le nombre d’examens nécessaires pour atteindre une performance donnée diminue nettement. Un projet qui aurait demandé plusieurs milliers d’examens il y a quelques années en demande aujourd’hui une fraction. Ce déplacement est réel et il faut le reconnaître. Il ne signifie pas la disparition du besoin mais son resserrement sur les cas où l’annotation apporte quelque chose que le modèle ne possède pas.La nature du travail se déplace
Ce second déplacement est moins visible et pèse davantage sur l’organisation. Le geste dominant passe du tracé à la correction et à la vérification, ce qui change le profil de compétence requis : moins de dextérité, davantage de jugement et de rigueur de convention. Ce déplacement a une conséquence que les projets sous-estiment. Corriger demande de savoir quand ne pas corriger, décision qui repose sur la connaissance du protocole et non sur la perception. Un annotateur assisté mal formé aux conventions produit un corpus pire qu’un annotateur non assisté bien formé.Certaines tâches résistent
C’est la catégorie dont dépend l’essentiel du besoin résiduel, et elle mérite d’être délimitée précisément. Les résultats cités désignent précisément où les modèles généralistes échouent : structures disjointes et bilatérales, formes non convexes, frontières conventionnelles. À quoi s’ajoutent les tâches où la difficulté n’est pas perceptive mais définitionnelle, c’est-à-dire celles où la question n’est pas où est la frontière mais où doit-on la placer. Ces tâches ne sont pas résiduelles. Elles constituent l’essentiel de ce qui a une valeur clinique, puisqu’une structure qu’un modèle généraliste segmente correctement sans données spécifiques est aussi une structure dont la segmentation ne différencie personne.Le déplacement vers l’évaluation
Un effet moins commenté mérite d’être signalé car il pourrait devenir le plus important. À mesure que l’entraînement demande moins de données annotées, la part relative de l’évaluation augmente. Un modèle affiné sur peu d’exemples doit néanmoins être évalué rigoureusement, et cette évaluation exige un corpus de test de haute qualité, annoté selon un régime exigeant et représentatif des conditions de déploiement. Cette évolution modifie sensiblement le profil de la demande. Moins d’examens, mais annotés avec un soin supérieur, avec annotation multiple et arbitrage, et couvrant délibérément les conditions difficiles plutôt que les cas moyens. Elle modifie aussi la nature de la valeur apportée. Constituer un corpus d’évaluation représentatif suppose de comprendre les conditions de déploiement, de stratifier par site et par population, et de mesurer la variabilité inter-experts pour situer la performance. Ce travail relève davantage de la méthode que de la production.Ce qui ne changera pas en segmentation d’images médicales
Trois éléments de la segmentation d’images médicales résistent à toute évolution des modèles, et il vaut la peine de les poser explicitement. Le premier de ces éléments est la définition. Aucun modèle ne peut décider si les muscles papillaires appartiennent à la cavité, si le septum entre dans la masse ventriculaire droite, ou jusqu’où prolonger une scissure incomplète. Ces questions sont conventionnelles et relèvent d’une décision humaine documentée. Le deuxième est la qualification clinique elle-même. Décider qu’une image montre bien la pathologie recherchée, et non un artefact ou une variante, relève d’un jugement médical qu’aucun corpus d’entraînement ne transfère intégralement. Le troisième est la mesure. Établir ce qui est atteignable suppose de connaître la variabilité entre experts sur la tâche, et cette borne ne se déduit d’aucun modèle. Elle se mesure, et elle se mesure sur des annotations humaines produites pour cela.Le cas des modalités mal couvertes
Une asymétrie structure le paysage et elle est rarement énoncée : tous les domaines de la segmentation d’images médicales ne progressent pas au même rythme. Le scanner concentre l’essentiel des corpus publics et des modèles disponibles, pour des raisons compréhensibles : standardisation des valeurs de densité, géométrie régulière, abondance des examens. C’est le domaine où l’automatisation progresse le plus vite et où le besoin d’annotation se resserre le plus nettement. L’imagerie par résonance magnétique suit avec un retard tenant à l’absence de valeurs absolues et à la multiplicité des séquences, qui multiplient les configurations à couvrir. L’échographie et la pathologie restent nettement en arrière. La première par sa dépendance à l’opérateur, la variabilité de qualité et la fréquence des artefacts ; la seconde par l’échelle gigapixel des lames et la variabilité de coloration entre laboratoires. Cette asymétrie a une conséquence directe pour un acheteur comme pour un prestataire. Les conclusions tirées du scanner ne se transposent pas, et un projet en échographie ou en pathologie se trouve aujourd’hui dans une situation comparable à celle du scanner il y a plusieurs années, avec les volumes et les méthodes qui l’accompagnent.Comment se préparer
Du point de vue d’une équipe qui construit un corpus de segmentation d’images médicales aujourd’hui, quatre décisions augmentent la durée de vie du travail. Annoter au format le plus riche que les données permettent, avec la géométrie complète et les métadonnées, puisque la conversion vers un format plus léger reste possible et l’inverse ne l’est pas. Conserver les annotations individuelles à côté du masque de référence, puisque les méthodes qui exploitent la variabilité se développent et que cette information est irrécupérable une fois fusionnée. Documenter le protocole et versionner, puisqu’un corpus dont les règles ne sont pas explicites ne peut être ni agrégé ni réévalué. Investir davantage dans le corpus d’évaluation que dans le corpus d’entraînement, puisque le second se rétrécit et le premier ne se rétrécit pas. Ces quatre décisions ont en commun de ne presque rien coûter au moment où elles sont prises et de ne pas se rattraper ensuite.Les signaux à suivre
Plutôt que des prédictions, quelques indicateurs permettent de suivre l’évolution sans dépendre des annonces. La performance zéro coup sur les structures difficiles, disjointes ou non convexes, est le meilleur indicateur de progrès réel, puisque c’est là que les modèles actuels échouent nettement. La quantité de données nécessaire pour refermer l’écart par affinage, qui détermine directement le volume d’annotation d’un projet. La robustesse au changement de domaine mesurée entre sites, puisque c’est le point faible du paradigme spécialisé et l’argument principal du paradigme de fondation. Et la disponibilité de modèles couvrant des structures et des modalités aujourd’hui mal servies, notamment en échographie et en pathologie, dont la couverture est bien inférieure à celle du scanner.Le cadre réglementaire comme frein et comme moteur
Une dimension extérieure à la technique pèse sur cette transition et elle joue dans deux sens opposés. Comme frein, l’exigence de traçabilité des données d’entraînement s’accommode mal d’un modèle dont le corpus est massif, hétérogène et partiellement non documenté. Un dispositif médical doit démontrer la provenance et la qualité de ses données, ce qui est plus simple sur un corpus constitué pour le projet que sur un modèle de fondation dont l’entraînement échappe au fabricant. Comme moteur, la même exigence favorise l’affinage sur données propres, puisqu’elle donne au fabricant la maîtrise d’au moins la dernière étape et un corpus documenté à présenter. Le régime qui émerge combine donc un modèle générique dont on hérite et une spécialisation documentée dont on répond. Ce partage a une conséquence pour la constitution des corpus. Le corpus d’affinage et le corpus d’évaluation deviennent les éléments que le fabricant doit maîtriser et documenter entièrement, ce qui renforce l’exigence de qualité sur des volumes réduits plutôt que de la relâcher.Les erreurs de jugement fréquentes
- Lire une performance obtenue avec des invites dérivées de la vérité terrain comme une performance autonome.
- Transposer un résultat obtenu sur des organes compacts à des lésions ou des structures disjointes.
- Conclure de la baisse des volumes d’entraînement que le besoin d’annotation disparaît.
- Négliger la robustesse au changement de domaine, qui décide souvent du déploiement.
- Alléger le corpus d’évaluation en même temps que le corpus d’entraînement.
- Attendre d’un modèle qu’il tranche une question conventionnelle.
- Comparer des paradigmes sans préciser d’où viennent les invites.
- Annoter dans un format pauvre en supposant que les besoins futurs seront les mêmes.
- Fusionner les annotations multiples en supprimant les individuelles.
- Alléger le contrôle qualité à mesure que l’assistance s’améliore.
- Transposer à l’échographie ou à la pathologie des conclusions tirées du scanner.
- Employer un modèle multi-organes public comme référence plutôt que comme point de départ.