Les articles précédents portaient sur la question « où se trouve cet objet ». Celui-ci porte sur une question différente : « quand commence cette action ». Le livrable n’est plus une position mais un intervalle, et cette bascule change les conventions, les métriques et les difficultés.
Cet article expose ce que la segmentation temporelle demande. Il prolonge l’article consacré à la vidéosurveillance et à la smart city.
Ce que la tâche recouvre
Quatre formulations coexistent en annotation vidéo temporelle. Leur confusion produit des corpus incompatibles. La classification de séquence, qui attribue une étiquette unique à un extrait entier sans localiser l’action dans le temps. La détection temporelle, qui localise le début et la fin de chaque occurrence dans un flux continu. La segmentation dense, qui attribue une étiquette à chaque instant, toute la durée étant couverte sans intervalle vide. Et la détection d’instant, qui réduit un événement à un point plutôt qu’à un intervalle. Une conséquence pratique importante en découle. Ces quatre formulations demandent un travail dont le coût varie dans un rapport important, et l’écart entre une classification de séquence et une segmentation dense dépasse celui entre deux nomenclatures de tailles différentes en annotation vidéo.La difficulté centrale
Cette propriété distingue la tâche de toutes les précédentes. Une action n’a pas de frontière temporelle nette, contrairement à un objet qui a un contour spatial. Trois manifestations en découlent. Le début d’un geste peut être situé à la préparation, au mouvement lui-même ou à son effet. La transition entre deux actions se fait par recouvrement plutôt que par rupture, un mouvement se terminant pendant que le suivant commence. Et l’intention précède l’action observable, ce qui laisse un intervalle où quelque chose se prépare sans être encore fait. Une observation importante en découle. Cette imprécision est intrinsèque et non corrigible par un annotateur plus attentif, ce qui impose de mesurer le désaccord sur les bornes plutôt que de l’attribuer à un défaut de rigueur.Définir une frontière temporelle
Cinq éléments composent la définition d’une action en annotation vidéo. Le second est celui qu’on oublie. Le nom de l’action, exprimé sans ambiguïté et distinct de ses voisines. Le critère de début, formulé en observation plutôt qu’en intention. Le critère de fin, distinct du début et rarement symétrique. Le traitement des interruptions, une action reprise après une pause constituant une ou deux occurrences. Et la tolérance admise sur les bornes, valeur chiffrée qui borne le désaccord acceptable. Une conséquence pratique s’ensuit pour un projet d’annotation vidéo. Le dernier élément transforme un désaccord en tolérance déclarée, ce qui permet de mesurer la conformité plutôt que de constater une divergence, et il coûte une ligne dans une convention.Ce que la granularité change
Cette décision structure tout le reste. Elle se prend avec l’utilisateur final. Une même séquence peut être décrite à plusieurs niveaux de détail. Trois niveaux se rencontrent. L’activité, qui couvre plusieurs minutes et regroupe de nombreux gestes. L’action, qui dure quelques secondes et constitue une unité fonctionnelle. Et le geste élémentaire, qui dure une fraction de seconde et compose une action. Une observation en découle. Le passage d’un niveau au suivant multiplie le nombre d’occurrences à annoter, ce qui fait de la granularité le principal levier de coût de cette tâche, et impose de la fixer par ce que la décision aval exige plutôt que par ce qui est descriptible.Les actions simultanées
Cette configuration complique la nomenclature. Elle est fréquente en annotation vidéo. Plusieurs actions peuvent coexister au même instant. Trois cas se distinguent. Un même acteur menant deux actions compatibles, marcher et parler par exemple. Plusieurs acteurs menant des actions différentes dans la même scène. Et une action collective qui coexiste avec les actions individuelles qui la composent. Une conséquence pratique importante en découle. Ces trois cas interdisent une segmentation à étiquette unique par instant, ce qui impose soit des pistes d’annotation parallèles soit une nomenclature à combinaisons, décision structurante qui doit être prise avant la production.Ce que la mesure doit rapporter
Quatre indicateurs rendent compte d’une segmentation temporelle. Ils diffèrent de ceux de la détection. Le recouvrement temporel entre l’intervalle prédit et l’intervalle de référence, équivalent temporel du recouvrement spatial. Le taux de détection au niveau de l’occurrence, une action trouvée avec des bornes imprécises restant une action trouvée. L’erreur sur les bornes rapportée séparément, distincte du fait d’avoir détecté ou non. Et la fragmentation, une action unique détectée comme plusieurs occurrences constituant un mode d’échec propre. Une observation en découle pour un projet d’annotation vidéo. Le troisième indicateur doit être comparé au désaccord entre annotateurs sur les mêmes bornes, comparaison qui distingue une imprécision du système d’une imprécision intrinsèque à la tâche.Comment l’annotateur travaille
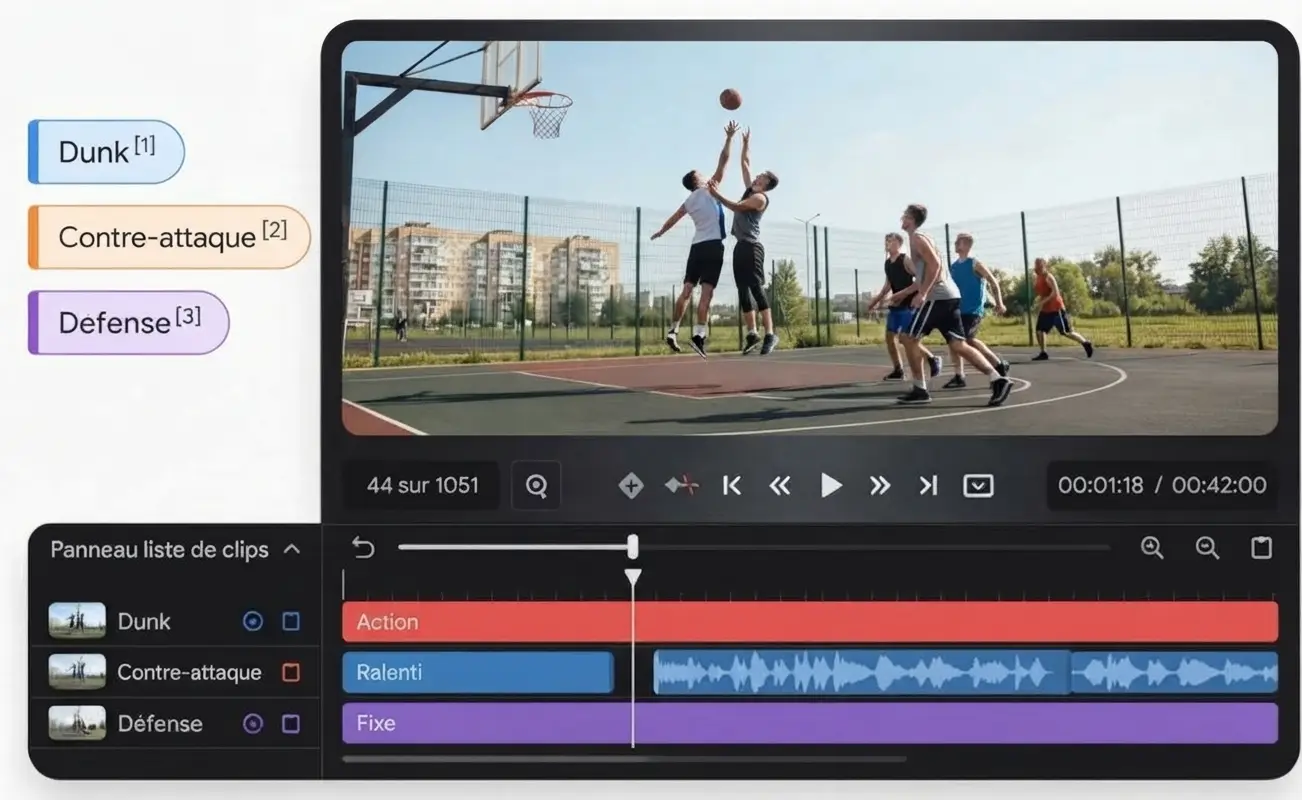
Cinq fonctions conditionnent la qualité de ce travail d’annotation vidéo. Elles diffèrent de celles du suivi. La navigation temporelle fine, permettant d’avancer image par image autour d’une frontière. La visualisation en piste, qui montre les intervalles déjà posés sur une ligne de temps. La lecture en boucle d’un segment, qui permet de juger une transition en la revoyant plusieurs fois. La vitesse variable, un survol rapide localisant les zones d’intérêt avant un examen précis. Et le report d’une décision, l’annotateur devant pouvoir marquer une frontière incertaine plutôt que trancher au hasard. Une conséquence pratique en découle. La troisième fonction est la plus déterminante et la plus souvent absente, une frontière ne se jugeant pas sur une lecture unique mais sur une comparaison entre plusieurs passages.Construire le vocabulaire d’actions
Cette opération détermine le plafond de tout ce qui suit et elle se conduit sur des séquences réelles. Quatre principes la gouvernent. Partir des décisions plutôt que des mouvements, deux gestes différents appelant la même réaction pouvant relever d’une classe unique. Vérifier chaque classe sur des exemples réels, une distinction évidente sur le papier se révélant souvent inapplicable sur des images. Compter les occurrences par classe sur un échantillon, une classe rencontrée deux fois en une heure ne pouvant pas être apprise. Et prévoir une classe pour ce qui ne relève d’aucune autre, faute de quoi les annotateurs rattachent arbitrairement les cas limites. Une conséquence pratique s’ensuit pour un projet d’annotation vidéo. Le troisième principe conduit régulièrement à fusionner des classes que le commanditaire distinguait, opération qui améliore le résultat et se présente mieux avant la production qu’après une performance décevante.Le contrôle qualité d’une segmentation temporelle
Quatre vérifications détectent les défauts propres à cette tâche d’annotation vidéo. La distribution des durées par classe, une occurrence anormalement brève ou longue signalant une erreur de bornes. La détection des chevauchements interdits, deux actions exclusives se recouvrant constituant une contradiction formelle. Le contrôle des intervalles non couverts en segmentation dense, un trou signalant un oubli plutôt qu’une absence d’action. Et la comparaison des bornes entre annotateurs sur un échantillon, qui mesure la tolérance réelle plutôt que la tolérance espérée. Une observation importante en découle. La première vérification est la plus économique et la plus révélatrice, la durée d’une action étant fortement contrainte par sa nature, ce qui rend une valeur aberrante immédiatement suspecte.Ce que cette tâche coûte
Cinq facteurs déterminent la charge d’annotation vidéo. Ils ne se réduisent pas à la durée. La granularité retenue, facteur dominant qui détermine le nombre d’occurrences. La densité d’actions, une séquence continue coûtant davantage qu’une séquence où il ne se passe rien. Le nombre de classes, dont la proximité compte davantage que le nombre. Le nombre de pistes parallèles, chaque acteur ou chaque dimension multipliant le travail. Et la précision exigée sur les bornes, une tolérance serrée demandant un examen image par image. Une conséquence pratique s’ensuit. Ces cinq facteurs se multiplient, et le rapport entre une classification de séquence et une segmentation dense multi-pistes dépasse celui que les commanditaires anticipent, ce qui rend le cadrage de la granularité déterminant.L’articulation avec le suivi
Ces deux tâches se combinent fréquemment. Leur relation mérite d’être posée. Une action est menée par un acteur, ce qui suppose de savoir lequel. Trois montages existent. La segmentation seule, qui décrit ce qui se passe sans dire qui agit, suffisante pour une scène à acteur unique. La segmentation rattachée à une piste, qui suppose un suivi préalable et permet une analyse individuelle. Et la segmentation indépendante par acteur, qui produit une piste temporelle par personne sans exiger un suivi continu. Une observation importante en découle pour un projet d’annotation vidéo. Le deuxième montage hérite des défaillances du suivi, une permutation d’identité réattribuant toutes les actions suivantes au mauvais acteur, ce qui rend la qualité du suivi déterminante pour une tâche qui semblait en être indépendante.Ce que cette tâche ne permet pas
Quatre limites méritent d’être posées. L’intention n’est pas observable, ce qui rend une classe fondée sur elle méthodologiquement fragile. Les bornes exactes n’existent pas, ce qui borne la précision atteignable indépendamment de tout effort. Une action masquée n’est pas annotable, l’occlusion ayant ici le même effet qu’en détection. Et le contexte manquant empêche parfois de trancher, une même séquence gestuelle recevant deux interprétations selon ce qui précède. Cette deuxième limite mérite d’être soulignée. Elle signifie qu’une exigence contractuelle sur la précision des bornes doit être comparée au désaccord entre experts avant d’être acceptée, faute de quoi elle engage sur un résultat que la tâche ne permet pas.Aborder un projet de segmentation temporelle
Cinq questions cadrent ce type de projet d’annotation vidéo. Quelle formulation, classification, détection, segmentation dense ou instant. Cette réponse change le coût dans un rapport important. Quelle granularité. Cette réponse détermine le nombre d’occurrences et doit venir de la décision aval. Des actions simultanées sont-elles possibles. Une réponse positive impose des pistes parallèles. Quelle tolérance sur les bornes. Cette réponse doit être chiffrée et comparée au désaccord mesuré. Et l’action doit-elle être rattachée à un acteur identifié. Cette réponse ajoute une dépendance au suivi. Ces cinq réponses déterminent la charge et la faisabilité. Les poser avant de commencer évite un corpus dont la granularité ne correspond pas à l’usage.Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen. La segmentation temporelle déplace l’imprécision de l’espace vers le temps sans la supprimer. Trois constats la composent. Une frontière temporelle est intrinsèquement floue, comme l’était un contour d’objet mal défini, et le désaccord entre annotateurs mesure cette imprécision plutôt qu’un défaut de méthode. La granularité joue ici le rôle que la nomenclature joue en détection, un niveau de détail supplémentaire multipliant le travail sans toujours servir la décision. Et la tolérance déclarée transforme un désaccord en spécification, ce qui rend mesurable ce qui autrement resterait un motif de litige. Ce constat rejoint celui que les séries précédentes ont établi à propos des frontières spatiales : lorsque la donnée ne porte pas de limite nette, la convention en crée une, et la qualité d’un corpus tient à la stabilité de cette convention plutôt qu’à sa justesse.Les erreurs les plus fréquentes
- Confondre classification de séquence et détection temporelle au cadrage.
- Fixer la granularité par ce qui est descriptible plutôt que par la décision aval.
- Ne pas écrire le critère de début en termes observables.
- Omettre le critère de fin, rarement symétrique du début.
- Ne pas chiffrer la tolérance admise sur les bornes.
- Supposer une étiquette unique par instant alors que des actions coexistent.
- Rapporter une performance globale sans isoler l’erreur sur les bornes.
- Attribuer le désaccord entre annotateurs à un défaut de rigueur.
- Négliger la dépendance au suivi lorsque l’action est rattachée à un acteur.
- Définir une classe fondée sur l’intention plutôt que sur l’observable.