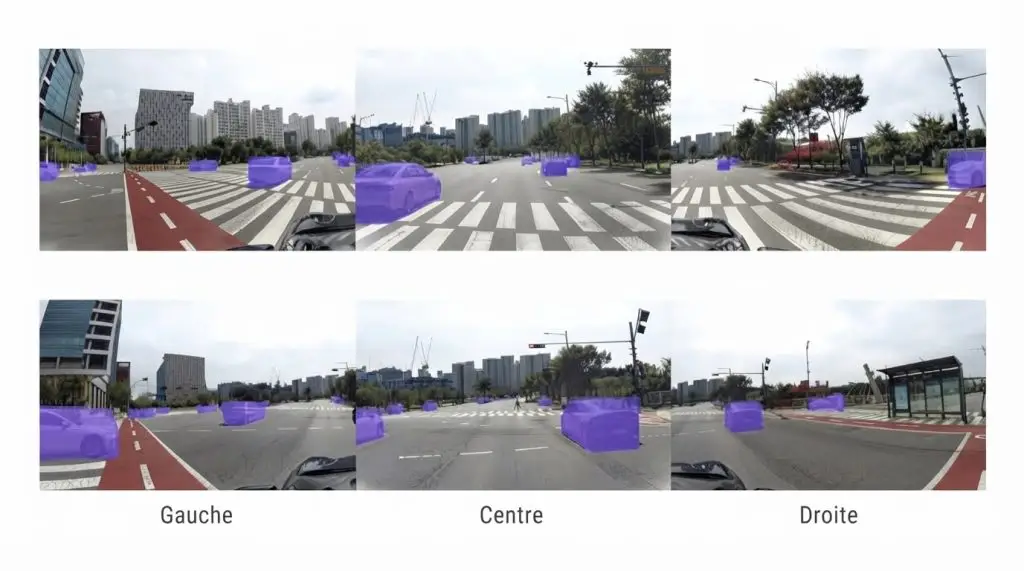
Un chiffre suffit à mesurer l’écart entre annoter des images et annoter de la vidéo. Un jeu de données de référence en conduite autonome décrit ainsi son volet suivi d’objets : 2 000 vidéos totalisant environ 400 000 images, annotées à cinq images par seconde, produisant 130 600 identités de trajectoire et 3,3 millions de boîtes englobantes.
Trois millions de boîtes pour deux mille vidéos de quarante secondes. Et encore, à cinq images par seconde seulement, soit une fraction de la cadence d’acquisition réelle. C’est l’ordre de grandeur qui définit le domaine : la vidéo ne se distingue pas de l’image par une difficulté conceptuelle mais par un facteur multiplicatif sur tout, le volume, le coût, et la place que prend la cohérence temporelle.
Ce guide couvre l’ensemble du domaine : les tâches, les formats, les conventions propres au temps, les métriques, l’organisation du travail et le contrôle qualité. Il sert de point d’entrée à un ensemble d’articles traitant chacun d’un aspect en détail.
Ce qui distingue l’annotation vidéo de l’annotation d’images
Une vidéo est une suite d’images, et c’est précisément ce que l’intuition retient de trop. Quatre différences en font un problème distinct.L’identité persistante
Sur une image isolée, il suffit de dire ce qu’on voit et où. Sur une vidéo, il faut dire que l’objet de l’image mille est le même que celui de l’image un. Cette continuité d’identité est l’information propre à la vidéo, celle qu’aucune annotation image par image ne produit, et c’est elle qui coûte le plus cher à établir et à contrôler.La redondance
Deux images consécutives sont presque identiques. Annoter chacune indépendamment revient à payer plusieurs dizaines de fois la même information, ce qui est économiquement absurde et méthodologiquement inutile. Toute la productivité du domaine repose sur l’exploitation de cette redondance, par interpolation, propagation ou suivi assisté.Les événements
Certaines informations n’existent pas sur une image : un geste, une action, une interaction, un changement d’état. Elles se définissent par un intervalle temporel plutôt que par une région spatiale, ce qui introduit une famille de tâches sans équivalent en annotation d’images.L’occultation comme situation normale
Sur une image, un objet partiellement caché est un cas limite. Sur une vidéo, un objet disparaît derrière un autre puis réapparaît, et la question de savoir s’il s’agit du même objet est centrale. L’occultation n’est pas une difficulté occasionnelle, c’est le mécanisme qui met à l’épreuve la cohérence d’identité.Les familles de tâches en annotation vidéo
Cinq familles couvrent la quasi-totalité des projets d’annotation vidéo, avec des coûts et des usages très différents.La détection image par image
La forme la plus simple : localiser des objets sur chaque image sans lien entre elles. Elle produit un corpus utilisable pour entraîner un détecteur, mais elle n’exploite pas la dimension temporelle et ne permet ni le suivi ni l’analyse de trajectoire. Elle reste pertinente lorsque l’usage visé est une détection instantanée.Le suivi multi-objets
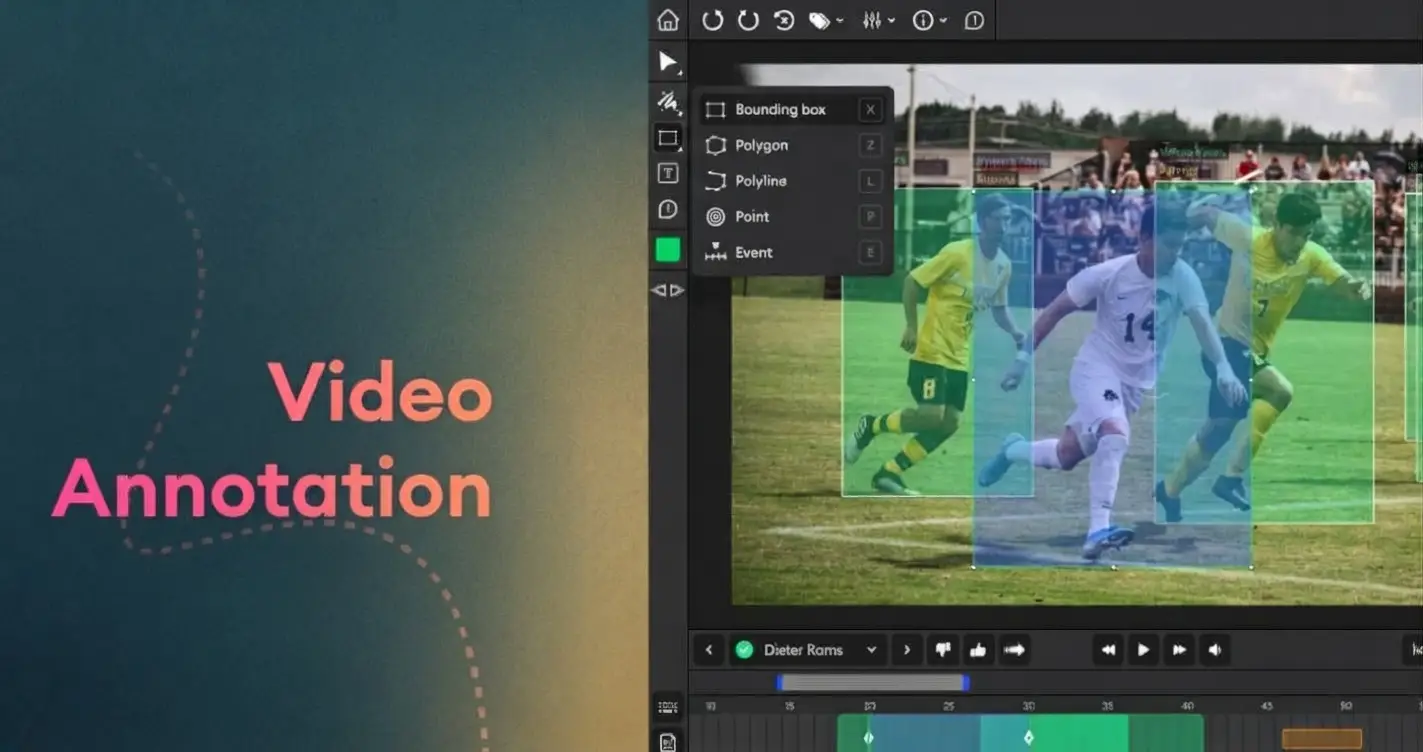
C’est la tâche emblématique du domaine. Chaque objet reçoit un identifiant maintenu tout au long de sa présence, ce qui permet de reconstituer sa trajectoire. La difficulté ne réside pas dans la localisation mais dans la gestion des identités lors des occultations, des croisements et des sorties de champ.La segmentation d’instances vidéo
Elle combine la précision au pixel et la persistance d’identité, ce qui en fait la tâche la plus coûteuse du domaine. Elle se justifie lorsque la forme précise de l’objet importe, en analyse de mouvement, en effets visuels ou en robotique de manipulation.L’annotation temporelle
Elle porte sur des intervalles plutôt que sur des régions : début et fin d’une action, phase d’un processus, occurrence d’un événement. Ses conventions propres, notamment la définition des bornes, en font une tâche à part entière, souvent sous-estimée parce qu’elle paraît simple.Les points clés et la pose
Le suivi de points articulaires ou de repères sur un objet déformable relève d’une cinquième famille. Elle combine les difficultés du suivi et de la précision, et elle est particulièrement sensible aux occultations partielles, un membre caché posant la question de l’annotation d’un point non visible.Les conventions temporelles propres à l’annotation vidéo
Ce sont elles qui font la cohérence d’un corpus d’annotation vidéo, et leur absence produit une variabilité que les métriques spatiales ne détectent pas.La naissance et la mort d’une identité
À quel moment un objet entrant dans le champ commence-t-il à être annoté ? Dès qu’un pixel est visible, à partir d’une proportion donnée, ou lorsqu’il est identifiable ? La même question se pose à la sortie. Sans règle écrite, chaque annotateur tranche différemment et les durées de trajectoire deviennent incomparables.La réapparition après occultation
C’est la convention la plus déterminante. Un objet caché pendant plusieurs secondes puis réapparaissant reçoit-il son identifiant d’origine ou un nouveau ? La réponse dépend de l’usage : un système de comptage exige la continuité, un système de détection instantanée s’en dispense. Le protocole doit fixer une durée maximale d’occultation au delà de laquelle l’identité est considérée comme perdue.L’annotation pendant l’occultation
Faut-il continuer à annoter un objet entièrement caché, en estimant sa position ? Les deux options existent et servent des usages différents. Annoter l’invisible permet d’apprendre à un modèle la permanence des objets ; ne pas l’annoter reflète ce qui est observable. Mélanger les deux dans un même corpus produit un signal contradictoire.Les bornes d’un événement
Un geste commence quand la main bouge, quand elle atteint l’objet, ou quand le contact s’établit ? Cette imprécision est la principale source de désaccord en annotation temporelle, et elle se règle par une définition écrite assortie d’exemples, jamais par un consensus implicite.Interpolation, propagation et pré-annotation
La productivité de l’annotation vidéo repose sur l’exploitation de la redondance, et trois mécanismes s’y emploient. L’interpolation entre images clés consiste à annoter une image toutes les n, l’outil calculant les positions intermédiaires. Elle est efficace sur les mouvements réguliers et devient fausse dès que la trajectoire change brusquement. La règle pratique consiste à placer une image clé à chaque changement de direction ou de vitesse plutôt qu’à intervalle fixe. La propagation par suivi automatique fait avancer l’annotation d’image en image en suivant l’apparence de l’objet, l’annotateur corrigeant lorsque le suivi décroche. Elle est nettement plus performante que l’interpolation sur les mouvements complexes, et sa limite tient aux occultations et aux objets visuellement similaires. La pré-annotation par modèle produit une proposition complète que l’annotateur corrige. Elle est aujourd’hui très efficace sur les objets courants et pose le problème d’ancrage déjà connu ailleurs : face à une proposition plausible, l’annotateur valide plus facilement qu’il ne corrige. La contre-mesure consiste à réserver une fraction du corpus à un travail sans assistance et à comparer. Ces trois mécanismes réduisent le coût d’un facteur important mais déplacent le travail plutôt qu’ils ne le suppriment. L’effort se concentre sur les images difficiles, croisements, occultations, changements rapides, qui sont précisément celles où la valeur d’apprentissage est la plus élevée.Les métriques de l’annotation vidéo
Les indicateurs spatiaux ne suffisent pas en annotation vidéo, et le domaine du suivi a développé des métriques propres qui s’appliquent aussi bien au contrôle d’un corpus qu’à l’évaluation d’un modèle. La littérature du suivi multi-objets emploie un ensemble stabilisé : les métriques liées aux identifiants de trajectoire comprennent la précision d’identité, le rappel d’identité, le score IDF1 et les changements d’identité entre segments de trajectoire, tandis que la précision globale du suivi mesure la performance conjointe du suivi et de la détection. Cette distinction est décisive pour le contrôle qualité. Une métrique de détection mesure si les objets sont trouvés et bien positionnés. Une métrique d’identité mesure si la continuité est respectée. Un corpus peut être excellent sur la première et médiocre sur la seconde, et c’est le cas le plus fréquent puisque la cohérence temporelle est ce que l’annotateur maîtrise le moins bien. Le nombre de changements d’identité est l’indicateur le plus directement interprétable en contrôle qualité. Il compte les fois où une trajectoire change d’identifiant sans raison, ce qui est une erreur d’annotation pure. Le rapporter par séquence, ventilé par cause probable, occultation, croisement, sortie de champ, oriente directement la correction.Les formats
Un projet d’annotation vidéo manipule trois choses qui doivent rester cohérentes : les images, les annotations et la relation entre les deux. Le premier point de vigilance est le référentiel temporel. Une annotation peut être rattachée à un numéro d’image, à un horodatage ou à un code temporel, et ces trois références ne coïncident pas nécessairement, notamment lorsque la vidéo a été rééchantillonnée ou lorsque la cadence est variable. Fixer la convention et la documenter est le préalable à toute conversion. Le deuxième est la relation entre le fichier vidéo et les images extraites. La plupart des outils travaillent sur des images extraites, et la correspondance entre l’image numéro n et la position dans le fichier d’origine doit être établie de façon reproductible. Un rééchantillonnage silencieux lors de l’extraction produit un décalage qui rend le corpus inutilisable pour toute analyse temporelle fine. Le troisième concerne la structure des annotations elles-mêmes. Le format issu des concours de suivi multi-objets est largement adopté et repose sur une ligne par objet et par image, comportant l’identifiant de séquence, le numéro d’image, l’identifiant d’objet et la géométrie. Sa simplicité en fait un bon dénominateur commun, et il se prête mal aux annotations riches, masques ou attributs multiples, qui appellent des formats structurés.Le coût d’une annotation vidéo et ce qui le gouverne
Le facteur multiplicatif de l’annotation vidéo est tel que les intuitions issues de l’annotation d’images conduisent systématiquement à sous-estimer. Quatre variables gouvernent le coût. La cadence retenue, qui multiplie directement le volume : annoter à vingt-cinq images par seconde coûte cinq fois plus qu’à cinq. Le nombre d’objets simultanés, qui multiplie le travail par image et complique la gestion d’identité. La densité d’occultations et de croisements, qui détermine la part du travail qui ne peut pas être automatisée. Et la primitive, une boîte coûtant une fraction d’un masque. La cadence mérite une attention particulière parce qu’elle est souvent choisie par défaut. Annoter à la cadence d’acquisition est rarement nécessaire : un objet se déplace peu entre deux images à vingt-cinq images par seconde, et la redondance est alors quasi totale. Le jeu de données cité en introduction annote à cinq images par seconde, ce qui reste suffisant pour apprendre le suivi tout en divisant le volume par cinq. Choisir cette cadence en fonction de la vitesse des objets et de l’usage visé est le premier levier d’économie d’un projet vidéo.Les domaines d’application et leurs contraintes
Les usages de l’annotation vidéo se répartissent en quelques familles dont les exigences diffèrent nettement. La mobilité et la conduite autonome constituent le domaine le plus documenté et le plus exigeant en volume. Les scènes y sont denses, les occultations permanentes et la cadence élevée, ce qui en fait le cas le plus coûteux. La convention de réapparition y est critique, un véhicule masqué par un autre puis réapparaissant devant être suivi de façon continue pour permettre la prédiction de trajectoire. La vidéosurveillance et l’analyse de flux posent un problème différent : peu d’objets mais des durées longues, et une exigence de continuité sur plusieurs minutes. Le comptage y étant souvent la finalité, un changement d’identité produit directement une erreur de comptage. Le sport et l’analyse de performance combinent des objets visuellement très similaires, des occultations fréquentes et une exigence de précision sur la position. C’est le domaine où les changements d’identité sont les plus difficiles à éviter, les joueurs d’une même équipe étant presque indiscernables. La vidéo industrielle et gestuelle, enfin, s’intéresse davantage aux événements qu’aux trajectoires. L’annotation y porte principalement sur des intervalles temporels, ce qui déplace la difficulté de la continuité d’identité vers la définition des bornes.Le contrôle qualité en annotation vidéo
Le dispositif suit la logique générale de l’annotation, avec une inflexion majeure : le contrôle doit porter sur le temps autant que sur l’espace. Un contrôle par échantillonnage d’images isolées, tel qu’il se pratique en annotation d’images, ne détecte pas les erreurs de continuité. Une identité échangée entre deux objets produit deux images parfaitement correctes prises séparément. La détection de cette erreur suppose d’examiner la séquence, ou de calculer les métriques d’identité sur la trajectoire complète. Trois mécanismes se combinent efficacement. Le contrôle automatique de cohérence, qui signale les anomalies de trajectoire, sauts de position, disparitions brèves, changements de taille incompatibles avec la dynamique. La revue de séquence, où un contrôleur visionne la vidéo annotée en accéléré, ce qui rend les incohérences temporelles immédiatement visibles là qu’elles sont invisibles image par image. Et le calcul des métriques d’identité sur un échantillon annoté en double. La revue en lecture accélérée mérite d’être signalée parce qu’elle est peu coûteuse et remarquablement efficace. L’œil humain détecte instantanément un identifiant qui saute ou une boîte qui décroche, alors que la même erreur est indétectable sur une capture fixe.L’organisation du travail
Deux principes distinguent l’organisation d’un projet d’annotation vidéo de celle d’un projet d’images. Le premier est l’unité de travail. Une séquence doit être annotée par une seule personne du début à la fin, car la cohérence d’identité ne se transmet pas d’un annotateur à l’autre. Découper une séquence entre plusieurs personnes produit des ruptures aux jonctions, et c’est une erreur d’organisation fréquente sur les longues vidéos. Le second est la charge cognitive. Le suivi d’identités multiples sur une séquence longue est une tâche mentalement exigeante, différente de la répétition d’un geste sur des images indépendantes. La fatigue s’y manifeste par des erreurs d’identité plutôt que par une imprécision de tracé, et elle appelle des sessions plus courtes que sur les tâches d’images. Ces deux principes ont une conséquence sur le dimensionnement : la capacité d’une équipe vidéo ne s’additionne pas aussi simplement que sur des images, puisque la parallélisation se fait au niveau de la séquence et non de l’image.Sélectionner ce qu’on annote
Le volume rend impossible d’annoter tout ce qui est collecté en vidéo, et la sélection devient donc un travail de conception à part entière. Trois niveaux de sélection se combinent. Le choix des séquences, qui doit couvrir la diversité des conditions, éclairage, densité, météo, plutôt que de privilégier les plus longues ou les plus faciles. Le choix des segments à l’intérieur d’une séquence, une vidéo de quarante secondes ne présentant pas un intérêt uniforme, les passages statiques apportant peu et les croisements beaucoup. Et le choix de la cadence, déjà évoqué. Une littérature récente s’intéresse à ce problème et souligne une particularité de la vidéo : les méthodes d’apprentissage actif existantes pour le suivi multi-objets opèrent principalement au niveau de l’image, ce qui est structurellement désaligné avec les modèles de suivi de bout en bout dont l’inférence et l’entraînement reposent sur des séquences multi-images. La conséquence pratique est que sélectionner des images isolées, comme on le ferait sur un corpus d’images, détruit le contexte temporel dont l’apprentissage a besoin. La sélection en annotation vidéo se fait par segment continu, jamais par image, ce qui est une différence méthodologique importante et souvent ignorée.Les erreurs les plus fréquentes
- Annoter à la cadence d’acquisition sans examiner si une cadence réduite suffit.
- Ne pas écrire la convention de réapparition après occultation.
- Mélanger dans un même corpus des objets annotés pendant l’occultation et d’autres non.
- Contrôler par échantillonnage d’images isolées, ce qui ne détecte aucune erreur d’identité.
- Découper une séquence entre plusieurs annotateurs.
- Confondre référentiel temporel et numéro d’image après rééchantillonnage.
- Placer les images clés à intervalle fixe plutôt qu’aux changements de trajectoire.
- Rapporter uniquement des métriques de détection sans métrique d’identité.
- Laisser la pré-annotation glisser vers de la validation passive sur les cas difficiles.
- Transposer une estimation de coût issue d’un projet d’images.