
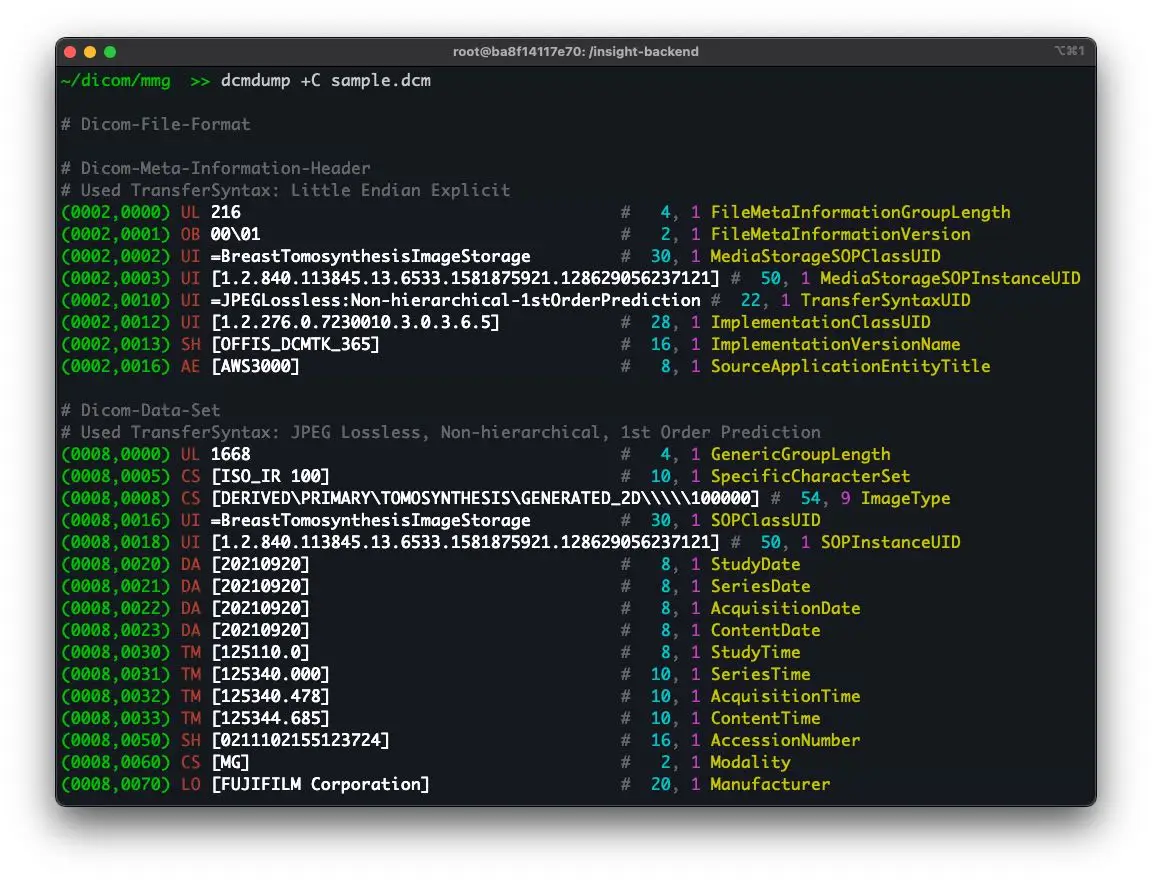
Le choix d’un format de segmentation d’images médicales ressemble à une décision technique mineure et il détermine en réalité la performance de la chaîne, la fidélité de l’information transmise et la capacité du corpus à revenir dans l’écosystème hospitalier.
Un groupe de travail du domaine formule le compromis sans détour : l’interopérabilité du format de segmentation du standard clinique a généralement été bonne, mais la performance de ses implémentations s’est révélée en général plusieurs ordres de grandeur plus lente que celle des formats de recherche pour des usages tels que l’exploitation de données de segmentation en apprentissage automatique.
Interopérabilité d’un côté, performance de l’autre, et un rapport qui se compte en ordres de grandeur. Cet article examine les familles de formats, ce que chacune porte réellement, les pertes de conversion et la façon de choisir. Il prolonge le guide complet de la segmentation d’images médicales.
Trois familles de représentation en segmentation d’images médicales
Un masque de segmentation d’images médicales peut être encodé de trois façons, et leurs différences ne sont pas seulement techniques. La première est le volume d’étiquettes : un fichier de mêmes dimensions que l’examen, où chaque voxel porte l’indice de la classe à laquelle il appartient. C’est la représentation la plus directe et la plus employée en recherche. La deuxième est l’objet de segmentation du standard clinique, qui encode le masque dans le même écosystème que l’examen source et conserve le lien vers lui. La troisième est la représentation par contours, historiquement liée à la radiothérapie, où la structure est décrite par une série de polygones plans plutôt que par des voxels. Ces trois familles ne sont pas trois encodages du même objet. Elles portent des informations différentes, et les convertir de l’une à l’autre entraîne des pertes qu’il vaut mieux connaître avant de choisir.Les formats de recherche
Cette famille regroupe plusieurs formats interchangeables en pratique, dont le plus répandu en imagerie volumique. Leur force est la simplicité. Un volume d’étiquettes se lit en une ligne dans la plupart des environnements de calcul, s’empile directement dans un tenseur et se manipule sans conversion. C’est ce qui explique leur domination dans les chaînes d’apprentissage. Leur seconde force est le poids. Le même groupe de travail relève qu’un fichier de recherche typique compressé peut être cent fois plus petit ou davantage que les données source, du fait de la redondance des données de segmentation, de vastes zones uniformes et de motifs répétitifs représentables plus efficacement par des codes courts. Leur faiblesse est ce qu’ils ne portent pas. Un volume d’étiquettes contient une géométrie et des indices numériques, rien d’autre. Il ne dit ni à quel patient il se rapporte, ni de quel examen il dérive, ni ce que l’indice trois désigne. Cette information doit être transportée à côté, par une convention de nommage ou un fichier annexe, et elle se perd facilement. Une contrainte structurelle mérite d’être signalée : un voxel ne porte qu’une seule étiquette. Cette représentation exclut donc nativement le recouvrement entre structures, ce qui pose problème dès que deux classes se superposent, une lésion et l’organe qui la contient par exemple.Le format de segmentation du standard clinique
Cette représentation résout précisément les faiblesses de la précédente, au prix des difficultés annoncées en introduction. Sa structure est différente. La documentation de l’outil de conversion de référence l’explique : les segmentations y sont organisées comme des listes de segments, chaque segment correspondant à un objet ou à une étiquette distincte, les segments pouvant se recouvrir, c’est-à-dire qu’un même voxel de l’image source peut porter plusieurs étiquettes, et chaque segment contenant l’information sur ce qu’il décrit et sur la méthode employée pour le produire. Trois différences en découlent. Le recouvrement est nativement possible, ce que le volume d’étiquettes interdit. Chaque segment porte sa propre description sémantique, plutôt qu’un simple indice numérique. Et la méthode de production est enregistrée, information qui a une valeur documentaire réelle dans un contexte régulé. La même source précise que la conversion nécessite, outre le masque, un fichier de métadonnées décrivant la segmentation et le jeu de données source correspondant à l’examen segmenté, ce dernier servant à peupler les attributs hérités du contexte, notamment les informations relatives au patient. C’est cette dernière propriété qui fait la valeur du format. Le masque n’est pas un fichier isolé mais un objet rattaché à son examen, à son patient et à son contexte d’acquisition, ce qui le rend directement exploitable par les systèmes hospitaliers.La représentation par contours
La troisième famille suit une logique entièrement différente et sa conversion pose un problème spécifique. La documentation citée l’expose clairement : de nombreux algorithmes de segmentation produisent une classification des voxels de l’image et ne se prêtent donc pas naturellement à une représentation par contours plans, ce qui exige une opération de conversion supplémentaire assortie d’un risque de perte d’information. Le mécanisme de perte est géométrique. Un masque de voxels converti en contours doit être approximé par des polygones, ce qui introduit une simplification. Le chemin inverse impose de rastériser les polygones, ce qui suppose de décider quels voxels sont à l’intérieur, et les conventions de rastérisation ne sont pas unifiées. La conséquence pratique est qu’un aller-retour entre les deux représentations ne restitue pas le masque d’origine. Sur une structure volumineuse la différence est négligeable ; sur une structure fine ou de faible surface, elle peut être substantielle. Une limitation d’outillage s’y ajoute. La même documentation indique que l’outil de conversion de référence ne prend pas en charge la conversion vers ou depuis cette représentation, et recommande de passer d’abord par une représentation rastérisée dans un format de recherche. Un projet travaillant avec des services de radiothérapie doit donc prévoir une chaîne à deux étapes plutôt qu’une conversion directe.L’orientation, piège numéro un des formats de segmentation d’images médicales
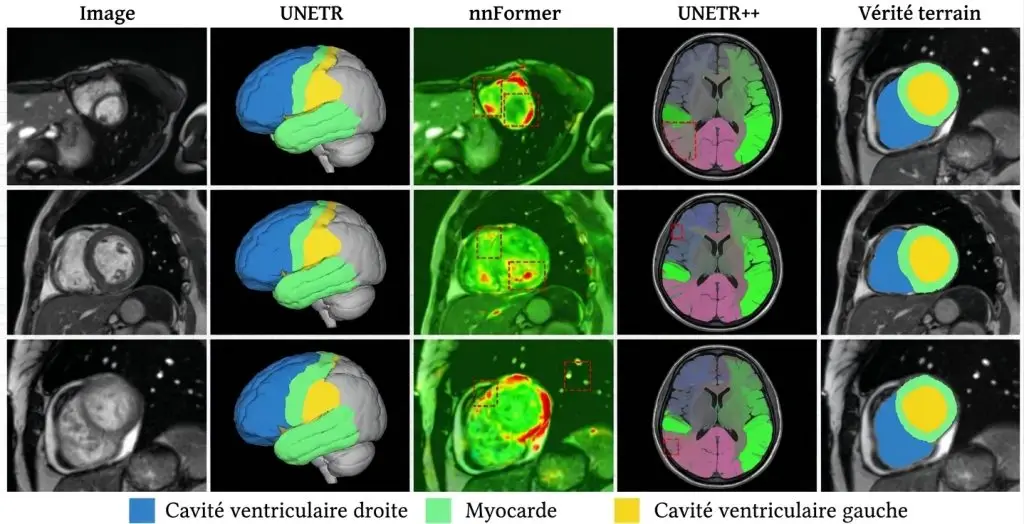
Si un seul point devait être retenu de cet article, ce serait celui-ci, car il produit les erreurs les plus coûteuses et les plus difficiles à détecter. Les conventions d’orientation ne coïncident pas entre familles de formats. Un exemple documenté en imagerie cardiaque l’illustre : l’orientation du patient par rapport au plan de l’image est différente entre un jeu de données de recherche et les images du standard clinique correspondantes, si bien que les images ont dû être tournées de cent quatre-vingts degrés pour être ramenées dans la même convention. Une rotation de cent quatre-vingts degrés est spectaculaire et paradoxalement moins dangereuse qu’un décalage subtil, parce qu’elle se voit. Les erreurs réellement coûteuses sont les inversions d’un seul axe, qui produisent un masque symétrique du bon. Sur une structure à peu près symétrique, foie et rate, poumons, hémisphères, cette erreur est invisible à l’œil et fausse tout. Deux mesures la préviennent. La première est le test d’aller-retour sur une structure de géométrie connue et franchement asymétrique, réalisé avant l’ouverture de la production et répété à chaque changement de version d’outil. La seconde est une vérification de latéralité automatique, une structure droite ne pouvant se trouver majoritairement à gauche, qui se programme en quelques lignes et détecte l’essentiel des inversions.Le poids et la performance en segmentation d’images médicales
Le compromis de segmentation d’images médicales annoncé en introduction mérite d’être détaillé, car il conditionne des choix d’architecture. Les formats de recherche sont compacts et rapides à lire, ce qui compte lorsqu’un entraînement parcourt le corpus des dizaines de fois. Sur un corpus volumineux, un écart d’un ordre de grandeur sur le temps de lecture se traduit en heures de calcul par époque. Le format du standard clinique est plus lourd et plus lent, pour des raisons structurelles : il transporte des métadonnées considérables et son encodage n’a pas été conçu pour un accès en masse. Le groupe de travail cité signale d’ailleurs que le standard prévoit des options de compression qui restent peu prises en charge par les outils libres courants. La conséquence est une architecture à deux régimes, qui est la pratique la plus répandue sur les projets matures. Le format clinique sert d’archive de référence et d’interface avec l’hôpital ; une conversion vers un format de recherche alimente l’entraînement. La conversion se fait une fois, sa fidélité est validée une fois, et les deux usages sont servis sans compromis.Les métadonnées qui accompagnent un masque
Quel que soit le format de segmentation d’images médicales retenu, une part de l’information ne réside pas dans le masque et doit être transportée séparément. Cinq éléments sont indispensables. La correspondance entre indice numérique et structure anatomique, sans laquelle le masque est illisible. La référence à l’examen source, qui permet de vérifier l’alignement. La version du protocole d’annotation appliquée, qui explique les conventions employées. L’identité de l’annotateur et du contrôleur, exigible en contexte régulé. Et la méthode de production, manuelle, assistée ou automatique, dont la valeur documentaire est réelle. Le format du standard clinique porte nativement une partie de ces éléments, ce qui est son principal avantage. Un format de recherche ne les porte pas, et un projet qui l’emploie doit organiser leur transport, par un fichier annexe structuré plutôt que par une convention de nommage. Cette dernière remarque mérite insistance. Encoder l’information dans le nom du fichier est la solution la plus fréquente et la plus fragile : elle survit mal aux réorganisations, aux copies et aux conversions, et elle rend l’automatisation dépendante d’analyses de chaînes de caractères qui cassent silencieusement.Choisir un format de segmentation d’images médicales selon la destination
Le choix se déduit de ce que le corpus de segmentation d’images médicales doit alimenter, et trois situations se distinguent nettement. Lorsque le corpus sert exclusivement à entraîner un modèle et reste dans un environnement de recherche, un format de recherche suffit et il est préférable. Ajouter la complexité du format clinique n’apporte rien et coûte en performance. Lorsque le corpus doit revenir dans l’écosystème hospitalier, pour être affiché dans un poste de lecture ou archivé, le format clinique s’impose. Le lien vers l’examen source et le contexte patient qu’il transporte ne se reconstituent pas. Lorsque le corpus alimente un dispositif médical régulé, le format clinique s’impose également, pour des raisons de traçabilité plutôt que d’affichage. La capacité à rattacher un masque à son examen, à son producteur et à sa méthode fait partie de la documentation exigible. Un quatrième cas mérite mention : le corpus destiné à durer et à servir plusieurs usages successifs. La règle prudente y consiste à annoter au format le plus commode et à livrer au format le plus riche, un corpus livré en coupes séparées sans métadonnées géométriques fermant définitivement des options qui ne se rouvrent pas.Le test d’aller-retour, contrôle indispensable
Une procédure de validation simple protège contre l’essentiel des défaillances de chaîne, et elle est trop rarement appliquée. Le principe consiste à faire parcourir à un masque le trajet complet qu’il empruntera en production : annotation, export, conversion, stockage, réimport, puis superposition sur l’examen source. La vérification porte sur trois points : l’alignement géométrique, la préservation de l’espacement inter-coupes et la conservation de la correspondance entre indices et structures. Trois précautions rendent ce test efficace. Employer une structure asymétrique, faute de quoi une inversion d’axe passe inaperçue. Inclure une petite structure, les erreurs d’arrondi et les simplifications se voyant d’abord sur elles. Et refaire le test après tout changement de version d’outil, les régressions sur ce point étant fréquentes et silencieuses. Le coût de cette validation se compte en heures. Le coût de son absence se compte en reprises de corpus, puisqu’une erreur géométrique découverte après la production impose de reconvertir l’ensemble et parfois de revérifier chaque masque.La conversion et ses pertes
Passer d’une famille de formats de segmentation d’images médicales à l’autre n’est jamais neutre, et connaître les pertes évite de les subir. Du volume d’étiquettes vers les contours, la perte porte sur la topologie. Un masque comportant un trou ou une composante isolée se traduit mal en polygones, et les conventions de représentation des cavités diffèrent entre implémentations. Une structure creuse peut se retrouver pleine après conversion sans qu’aucune alerte ne le signale. Des contours vers le volume d’étiquettes, la perte porte sur la précision sous-voxel. Un polygone décrit une frontière continue, et la rastérisation la ramène à une grille, ce qui introduit une différence systématique de volume selon la règle d’inclusion retenue. Cette différence est faible en valeur relative et suffisante pour rendre deux mesures non comparables. Entre formats de recherche et format clinique, la perte porte sur les métadonnées. Le format clinique transporte l’identifiant de l’examen source, la description des structures et parfois le codage terminologique ; les formats de recherche ne conservent que la géométrie. Une conversion descendante est donc irréversible sur ce plan. La conséquence pratique est de conserver la représentation la plus riche produite et de générer les autres à la demande, plutôt que de convertir puis de jeter l’original. Le stockage coûte moins cher que la reconstitution.Le cas des structures multiples
Une difficulté spécifique de la segmentation d’images médicales se présente dès que plusieurs structures peuvent occuper le même espace. Le volume d’étiquettes impose un choix : chaque voxel appartient à une classe et à une seule. Face à une lésion contenue dans un organe, il faut donc décider si le voxel appartient à la lésion ou à l’organe, ce qui rend impossible de calculer à la fois le volume de l’organe entier et celui de la lésion à partir du même fichier. Deux contournements existent. Le premier consiste à produire un fichier par structure, ce qui autorise le recouvrement au prix d’une multiplication du nombre de fichiers. Le second consiste à définir une hiérarchie explicite, l’organe étant reconstitué par union de ses composantes, ce qui suppose que cette règle soit documentée et appliquée sans exception. Le format clinique évite le problème puisqu’il autorise nativement le recouvrement. C’est un argument en sa faveur sur les ontologies hiérarchiques, notamment en imagerie thoracique où parenchyme, lobes et lésions s’emboîtent. Cette question doit être tranchée au cadrage et non à la livraison, car elle détermine la structure des fichiers produits et se corrige mal après coup.Ce qu’il faut convenir avec l’équipe destinataire
Le format est le point de contact entre le prestataire de segmentation d’images médicales et l’équipe qui exploitera le corpus, et les malentendus y sont fréquents. Cinq points gagnent à être écrits avant la production. Le format de livraison exact et sa version. La convention d’orientation et de géométrie, avec un exemple de fichier validé conjointement. La structure des fichiers, un par structure ou un volume multiclasse. Le transport des métadonnées, fichier annexe ou format porteur. Et la procédure de validation, qui doit être exécutée sur un lot réduit avant l’ouverture de la production. Ce dernier point est le plus important et le moins pratiqué. Livrer un premier lot réduit, le faire valider techniquement par l’équipe destinataire et corriger avant de produire le reste coûte quelques jours et évite la découverte tardive d’une incompatibilité sur l’ensemble du corpus.La nomenclature des structures
Un aspect des formats de segmentation d’images médicales est régulièrement traité comme un détail alors qu’il conditionne l’exploitabilité du corpus : la façon dont les structures sont nommées. Trois niveaux de rigueur se rencontrent. Le plus courant repose sur des chaînes libres, où chaque projet invente ses noms, ce qui fonctionne en interne et rend toute agrégation entre corpus impossible. Le deuxième repose sur une liste contrôlée propre au projet, documentée et stable, ce qui suffit à la plupart des usages. Le troisième s’appuie sur un codage terminologique standard, que le format clinique permet de transporter, et qui rend la structure identifiable sans connaissance du projet. Ce troisième niveau demande un effort initial modeste et il a deux bénéfices que les projets sous-estiment. Il rend le corpus agrégeable avec d’autres, ce qui a une valeur croissante à mesure que les jeux publics se multiplient. Et il supprime une classe entière d’ambiguïtés, un nom libre pouvant désigner des périmètres anatomiques différents selon la spécialité qui l’emploie. La règle pratique consiste à décider ce niveau au cadrage plutôt que d’y venir après coup. Ajouter un codage terminologique à un corpus livré suppose de rouvrir chaque fichier, alors que le porter dès la production ne coûte qu’une colonne dans le protocole.Les erreurs les plus fréquentes
- Choisir un format sans savoir ce que le corpus devra alimenter.
- Attendre d’un aller-retour entre représentations raster et contours qu’il restitue le masque d’origine.
- Tester l’alignement sur une structure symétrique, ce qui masque les inversions d’axe.
- Ne pas refaire le test de conversion après un changement de version d’outil.
- Encoder les métadonnées dans le nom des fichiers plutôt que dans un fichier structuré.
- Employer un volume d’étiquettes sur une ontologie où les structures se recouvrent.
- Perdre l’espacement inter-coupes lors d’une extraction en images.
- Livrer sans avoir fait valider un lot réduit par l’équipe destinataire.
- Utiliser le format clinique dans une boucle d’entraînement, au prix d’une performance dégradée.
- Trancher la question du recouvrement à la livraison plutôt qu’au cadrage.