Toutes les erreurs de description ne se valent pas. Certaines se corrigent en une journée, d’autres se découvrent des mois plus tard et obligent à reprendre l’ensemble du corpus. Ce qui les sépare tient rarement à leur fréquence.
Cet article expose ce classement. Il prolonge l’article consacré aux
données synthétiques.
Ce qui rend une erreur coûteuse
Cinq facteurs déterminent le prix d’un défaut de labellisation de données.
Le moment précis où il devient visible dans le projet.
La part exacte du corpus qu’il affecte simultanément.
Sa capacité à se répéter de manière parfaitement systématique.
La difficulté de le repérer par un simple contrôle ordinaire.
Et le travail nécessaire pour le corriger une fois identifié.
Une conséquence pratique importante en découle. Le premier facteur domine tous les autres, un même défaut coûtant quelques heures s’il est repéré au premier lot et plusieurs mois s’il se découvre en usage réel.
Ce que l’omission coûte
Cinq caractéristiques font de ce défaut de labellisation de données le plus cher.
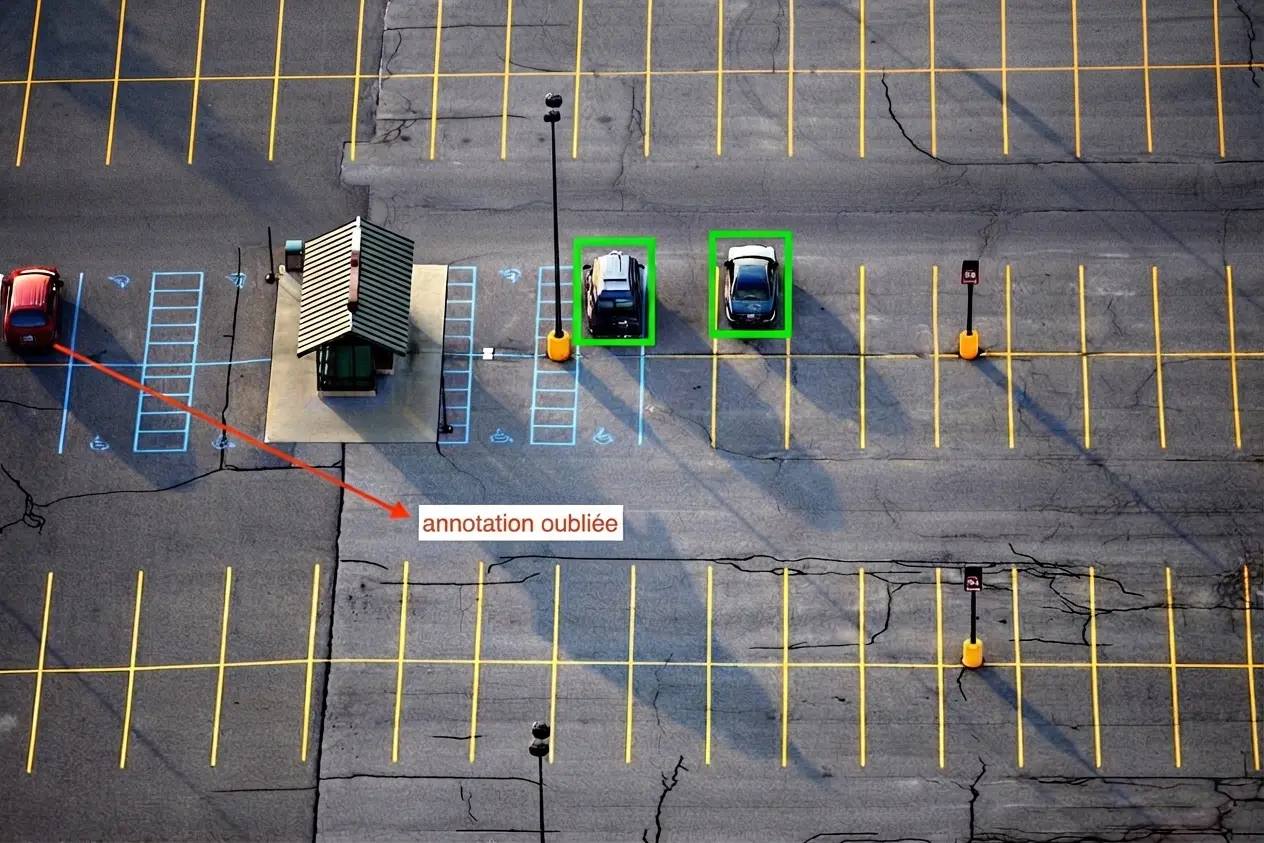
Il n’apparaît nulle part dans le livrable finalement produit.
Aucun contrôle portant sur le seul existant ne le détecte.
Il enseigne au système entraîné à ignorer ce qu’il devrait voir.
Sa mesure suppose de reprendre entièrement les mêmes données.
Et sa correction impose de rouvrir le corpus tout entier.
Une observation importante en découle pour un projet de labellisation de données. La deuxième caractéristique explique sa persistance, un dispositif vérifiant la justesse de ce qui figure dans le corpus restant parfaitement muet sur ce qui n’y figure pas.
Ce que la convention erronée produit
Cinq effets suivent une règle mal définie au départ.
Elle s’applique de façon parfaitement cohérente partout.
Tous les indicateurs d’accord viennent la valider sans réserve.
Elle affecte l’ensemble du corpus et non une simple fraction.
Elle ne se révèle qu’au moment de l’usage réel du système.
Et sa correction demande une reprise entièrement complète.
Une conséquence pratique s’ensuit. Le deuxième effet la rend redoutable, un corpus appliquant fidèlement une mauvaise convention obtenant de meilleurs scores qu’un corpus hésitant sur la bonne.
Ce que le biais systématique entraîne
Cinq propriétés distinguent ce défaut de labellisation de données du bruit ordinaire.
Il porte toujours exactement dans la même direction.
Il ne se compense jamais entre les opérateurs.
Il se transmet intégralement au système finalement entraîné.
Il passe totalement inaperçu tant qu’on regarde une simple moyenne.
Et il se corrige très mal une fois le corpus produit.
Une observation en découle. La quatrième propriété explique qu’il survive au contrôle, un décalage constant restant invisible dans un taux global alors qu’une ventilation par opérateur le fait apparaître immédiatement.
Ce que le défaut de sélection produit
Cinq conséquences suivent un corpus mal choisi au départ.
Le système apprend un monde très différent de celui qu’il rencontrera.
Les indicateurs restent pourtant excellents sur le corpus lui-même.
L’échec se manifeste dès les toutes premières données réelles.
Aucun contrôle portant sur la description ne pouvait le signaler.
Et sa correction impose une nouvelle acquisition entièrement complète.
Une conséquence pratique importante en découle pour un projet de labellisation de données. La quatrième conséquence place ce défaut hors de portée du prestataire d’annotation, un corpus parfaitement décrit restant inutilisable si les données de départ ne représentaient pas l’usage, ce qui rend cette responsabilité entièrement celle du client.
Ce que la catégorie rare révèle
Cinq observations concernent les classes les moins représentées.
Elles pèsent très peu dans un taux global de qualité.
Elles souffrent le plus d’une définition restée floue.
Elles concentrent pourtant souvent l’intérêt réel de l’usage.
Elles s’améliorent très mal par la simple augmentation du volume.
Et leur échec finit par passer pour un résultat acceptable.
Une conséquence pratique importante en découle pour un projet de labellisation de données. La troisième observation crée le paradoxe central, un corpus excellent sur les situations courantes échouant précisément sur celles pour lesquelles le système avait été commandé.
Aborder les défauts d’un corpus
Cinq questions cadrent les défauts d’un corpus de labellisation de données.
L’omission est-elle mesurée. Sinon elle reste invisible.
La convention a-t-elle été éprouvée. Elle affecte tout le corpus.
Les taux sont-ils ventilés. Un biais s’y cache toujours.
Les classes rares sont-elles isolées. Elles portent l’enjeu réel.
Et le contrôle a-t-il eu lieu tôt. Le coût dépend du moment.
Ces cinq réponses déterminent le risque porté par un corpus. Les poser tôt évite une reprise que rien ne rendait inévitable.
Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen.
Le coût d’un défaut tient au moment de sa découverte.
Trois constats la composent.
L’omission n’apparaît dans aucun contrôle de l’existant.
Une mauvaise convention appliquée fidèlement obtient de bons scores.
Et un biais systématique reste invisible dans une moyenne.
Ce constat prolonge les chapitres précédents, les défauts les plus chers étant précisément ceux que le dispositif habituel ne cherche pas.
Les erreurs les plus fréquentes
- Mesurer la justesse sans jamais mesurer l’omission.
- Figer une convention sans l’avoir éprouvée sur un lot.
- Lire un taux global sans aucune ventilation.
- Juger un corpus sur ses classes les plus fréquentes.
- Reporter le premier contrôle à la fin du projet.
- Confondre un biais systématique et du bruit aléatoire.
- Traiter une classe rare comme une classe ordinaire.
- Accepter un accord élevé comme preuve de qualité.
- Corriger un défaut sans reprendre les lots antérieurs.
- Négliger un écart parce qu’il porte sur peu d’éléments.
Ce que le moment de la découverte change
Cinq étapes marquent le coût croissant d’un même défaut.
Repéré dès le lot d’essai, il se corrige avant toute production.
Repéré au premier lot, il coûte la reprise de ce seul lot.
Repéré en cours de projet, il coûte la reprise des lots antérieurs.
Repéré au moment de la livraison, il coûte une renégociation complète.
Et repéré en usage, il coûte le corpus ainsi que le temps déjà passé.
Une observation importante en découle pour un projet de labellisation de données. Ces cinq étapes séparent des ordres de grandeur plutôt que des pourcentages, ce qui justifie de consacrer au premier contrôle un effort disproportionné par rapport au volume qu’il examine.
Ce que la dérive en cours de projet produit
Cinq observations caractérisent ce défaut particulier.
Le corpus reste parfaitement cohérent à l’intérieur de chaque lot.
Les premiers lots et les derniers appliquent deux conventions.
Aucun contrôle portant sur un seul lot isolé ne le détecte.
Il apparaît seulement lorsqu’on compare des lots éloignés dans le temps.
Et sa correction impose de choisir laquelle des deux règles conserver.
Une conséquence pratique importante en découle pour un projet de labellisation de données. La troisième observation explique sa fréquence, un dispositif de contrôle vérifiant chaque lot à sa production validant successivement deux conventions incompatibles sans jamais les confronter l’une à l’autre.
Trois décisions qui évitent les défauts les plus chers
Trois décisions protègent un projet de labellisation de données.
Mesurer l’omission dès le premier lot plutôt qu’en fin de projet.
Éprouver la convention sur un échantillon avant de la figer.
Et ventiler chaque taux par opérateur et par catégorie.
Ces trois décisions coûtent quelques jours, elles précèdent la production de volume, et leur absence expose précisément aux trois défauts que rien ne rattrape ensuite.
La question qui classe un défaut
Une question détermine le coût d’un défaut de labellisation de données.
Le défaut est-il réparti au hasard ou porté par une règle.
Réparti au hasard, une inattention ou une hésitation isolée, il se dilue dans le volume et se corrige par une reprise ciblée.
Porté par une règle, une convention mal comprise ou un opérateur constant dans son écart, il affecte tout ce qui relève de cette règle et se corrige mal.
Cette question relève de la structure du défaut et non de sa fréquence, elle se pose dès le premier contrôle, et elle sépare une reprise de quelques heures d’une reprise de plusieurs semaines.
Trois vérifications sur un corpus livré
Trois contrôles qualifient un corpus de labellisation de données.
La présence d’un taux d’omission mesuré séparément.
La ventilation des résultats par opérateur et par catégorie.
Et une comparaison entre les premiers lots et les derniers.
Ces trois contrôles se posent en une question chacun, ils ne demandent aucune compétence technique, et leur absence laisse subsister précisément les défauts qu’aucune reprise partielle ne corrigera.
Ce que le prestataire apporte ici
Quatre apports préviennent les défauts les plus coûteux.
Un contrôle conduit dès le premier lot plutôt qu’au moment de la livraison.
Une mesure de l’omission publiée dès le démarrage du projet.
Une comparaison périodique entre lots éloignés dans le temps.
Et un signalement de toutes les classes rares traitées de façon incertaine.
Une conséquence pratique importante en découle. Le troisième apport ne figure dans aucun cahier des charges et évite le défaut le plus discret, une dérive de convention ne se voyant que lorsque deux lots produits à plusieurs semaines d’écart sont mis côte à côte.
Ce que la correction d’un défaut demande
Cinq travaux composent une reprise sérieuse.
L’identification précise de la population réellement affectée.
La correction du référentiel avant toute reprise effective.
La reprise de tous les lots produits sous l’ancienne règle.
Une nouvelle mesure vérifiant que le défaut a bien disparu.
Et une trace écrite de ce qui a été modifié ainsi que des raisons.
Une observation importante en découle pour un projet de labellisation de données. Le premier travail décide du coût de tous les autres, une population mal délimitée conduisant soit à reprendre bien plus que nécessaire soit à laisser subsister une partie du défaut, ce qui rend cette délimitation plus déterminante que la reprise elle-même.
Ce que ce chapitre laisse au suivant
Ces défauts se produisent dans un travail que des personnes exécutent.
Trois questions restent ouvertes en labellisation de données.
Ce que les conditions de travail changent à la qualité produite.
Ce qu’un donneur d’ordre doit à ceux qui décrivent ses données.
Et comment ces questions se posent dans une chaîne de sous-traitance.
Ces trois questions relèvent de l’éthique de la labellisation, qui constitue l’objet du chapitre suivant.
Ce que le client doit surveiller ici
Cinq signaux annoncent un défaut coûteux en formation.
Un taux d’accord élevé accompagné d’aucune mesure de l’omission.
Un rapport ne présentant qu’un seul chiffre unique et global.
Une absence totale de remontées de cas depuis plusieurs semaines.
Un référentiel resté figé depuis le démarrage du projet.
Et des classes rares dont les résultats ne sont jamais présentés à part.
Une conséquence pratique importante en découle pour un projet de labellisation de données. Le troisième signal se lit à l’envers de l’intuition, une absence de questions signalant rarement un référentiel parfait et plus souvent des opérateurs qui tranchent seuls, ce qui prépare exactement le type de défaut que ce chapitre décrit.
Ce que ce chapitre partage avec les précédents
Trois constats reviennent depuis le début du parcours.
Un chiffre global masque toujours un échec sur une population.
Le défaut dominant reste absent du livrable lui-même.
Et le cadrage décide de bien plus que l’exécution.
Une observation importante en découle pour un projet de labellisation de données. Ces trois constats désignent le même dispositif, une mesure conçue pour vérifier ce qui figure dans le corpus ne pouvant par construction rien dire de ce qui aurait dû s’y trouver, ce qui explique que les défauts les plus chers survivent à des contrôles rigoureux.
Ce que ce sujet a de particulier
Quatre traits distinguent cette question des autres du parcours.
Elle ne se traite pas au moment où elle se produit.
Elle classe les défauts par coût plutôt que par fréquence.
Elle désigne des défauts que le contrôle ordinaire valide.
Et elle porte sur ce que le corpus ne contient pas.
Une conséquence pratique importante en découle pour un projet de labellisation de données. Le deuxième trait renverse l’ordre habituel des priorités, un défaut rare et structurant méritant davantage d’attention qu’un défaut fréquent et dispersé, ce qui contredit l’intuition qui gouverne la plupart des dispositifs de contrôle.
Ce que le défaut de documentation coûte
Cinq conséquences suivent un corpus livré sans son référentiel.
Personne ne sait plus quelle convention avait été appliquée.
Une extension ultérieure produit un corpus finalement incohérent.
Les cas limites déjà tranchés doivent tous être redécouverts.
Un désaccord portant sur la qualité ne peut plus être arbitré.
Et le corpus perd une part de sa valeur à chaque année écoulée.
Une observation importante en découle pour un projet de labellisation de données. Ce défaut ne dégrade aucune donnée et coûte pourtant très cher, un corpus parfaitement décrit devenant inexploitable dès lors que plus personne ne sait ce que ses catégories recouvraient exactement.
Ce que le premier lot doit chercher
Cinq examens valent d’être conduits avant toute production de volume.
Une reprise complète d’un échantillon afin de mesurer l’omission.
Une ventilation des écarts par opérateur et par catégorie.
Un examen entièrement séparé des classes les moins représentées.
Une confrontation des cas limites rencontrés aux règles écrites.
Et une vérification que les données correspondent bien à l’usage prévu.
Une conséquence pratique importante en découle pour un projet de labellisation de données. Ces cinq examens portent chacun sur un des défauts décrits dans ce chapitre, ce qui fait du premier lot le seul moment où tous se corrigent encore pour un coût négligeable.
Ce que le défaut de format entraîne
Cinq observations concernent ce défaut purement technique.
Il n’affecte en rien la justesse même des descriptions produites.
Il empêche pourtant toute exploitation immédiate du corpus.
Il se découvre au moment de la toute première lecture par le client.
Il se corrige le plus souvent par une simple conversion automatique.
Et il coûte parfois plusieurs semaines lorsqu’une information essentielle manque.
Une observation importante en découle pour un projet de labellisation de données. La dernière observation distingue deux situations très différentes, une conversion de structure se réglant en quelques heures alors qu’une information jamais collectée oblige à rouvrir le corpus, ce qui rend la validation du format aussi urgente que celle de la convention.
Trois questions à poser devant un corpus reçu
Trois questions précèdent l’acceptation d’un livrable.
Quel taux d’omission a été mesuré et sur quel échantillon.
Les résultats varient-ils selon l’opérateur ou la catégorie.
Et les premiers lots ressemblent-ils aux derniers.
Ces trois questions se posent en quelques minutes, elles ne demandent aucune compétence technique, et leur absence conduit à accepter un corpus dont les défauts se révéleront quand plus rien ne pourra les corriger.
Ce que ce chapitre suppose du prestataire
Cinq pratiques distinguent une production honnête d’une production rassurante.
Chercher l’omission plutôt que d’attendre que le client la réclame.
Signaler une dérive avant que le client ne la constate.
Comparer des lots éloignés dans le temps sans que rien n’y oblige.
Isoler les classes rares même lorsqu’elles dégradent le résultat.
Et proposer une reprise plutôt que de livrer un corpus visiblement douteux.
Une conséquence pratique importante en découle. La dernière pratique coûte immédiatement et protège durablement, un corpus livré avec un défaut connu du seul prestataire finissant toujours par se découvrir, ce qui transforme une reprise assumée en un litige que rien ne désamorce.
Ce que ces défauts coûtent réellement
Cinq postes composent la dépense d’une reprise tardive.
Le travail de description entièrement refait sur la population concernée.
Le contrôle qualité intégralement appliqué une seconde fois.
Le temps d’entraînement définitivement perdu sur le corpus défectueux.
Le retard pris par tout ce qui dépendait directement de ce corpus.
Et la confiance durablement entamée entre les deux parties.
Une observation importante en découle pour un projet de labellisation de données. Le quatrième poste dépasse souvent tous les autres réunis, une équipe technique ayant attendu six mois un corpus utilisable perdant davantage en calendrier que le coût de la reprise elle-même ne le laisse supposer.
Ce que le défaut d’un seul opérateur produit
Cinq observations concernent un écart individuel constant.
Il affecte uniquement la part du corpus que cette personne a traitée.
Il reste parfaitement invisible dans un taux calculé sur l’ensemble.
Il apparaît en revanche immédiatement dès qu’on ventile par personne.
Il se corrige par une reprise ciblée sur ces seuls lots.
Et il révèle presque toujours une consigne qui a été mal comprise.
Une conséquence pratique importante en découle pour un projet de labellisation de données. La dernière observation change la façon de traiter ce défaut, un écart individuel constant désignant un point du référentiel que cette personne a lu autrement, ce qui appelle une clarification écrite plutôt qu’un rappel adressé à elle seule.
Ce que ce classement change à l’organisation
Cinq conséquences suivent une lecture par coût plutôt que par fréquence.
Le premier lot mobilise un effort disproportionné par rapport à son volume.
Le contrôle cherche d’abord l’absent avant de vérifier le présent.
Les ventilations précèdent désormais la lecture du taux global.
Les classes rares font systématiquement l’objet d’un examen séparé.
Et la comparaison entre les lots anciens et les plus récents devient périodique.
Une observation importante en découle pour un projet de labellisation de données. Ces cinq conséquences ne coûtent presque rien une fois installées, l’essentiel de l’effort tenant à décider de les appliquer plutôt qu’à les conduire, ce qui les rend accessibles à des projets de toute taille.
Ce qu’il faut retenir
Les défauts les plus chers sont ceux que le contrôle ne cherche pas.
Trois lectures se dégagent. L’omission n’apparaît dans aucun contrôle portant sur l’existant, ce qui la rend invisible jusqu’à l’usage réel et impose alors de rouvrir le corpus entier. Une convention erronée appliquée fidèlement obtient de meilleurs scores qu’une bonne convention appliquée avec hésitation, ce qui la fait valider par tous les indicateurs. Et un biais systématique reste invisible dans une moyenne alors qu’une ventilation par opérateur le fait apparaître immédiatement.
Pour les conditions de travail, l’article consacré à l’
éthique de la labellisation le détaille. Pour les évolutions du métier, l’article sur les
tendances de la labellisation l’expose.
Pour approfondir les modalités d’exécution, les formats pris en charge et les dispositifs de contrôle applicables, vous pouvez consulter notre page dédiée à l’
annotation 2D et 3D. Et si vous préparez un projet de labellisation,
échangeons sur votre besoin.