Mesurer la qualité d’une classification de nuage de points pose un problème que l’imagerie ne rencontre pas. Il n’existe pas d’objet de référence évident, la surface n’est pas plane, et les erreurs qui comptent ne sont pas celles que les métriques usuelles pénalisent.
Cet article expose comment évaluer une classification de LiDAR aérien, quelles métriques employer et pourquoi les indicateurs globaux trompent. Il prolonge l’article consacré à l’annotation.
Pourquoi l’évaluation diffère de l’imagerie
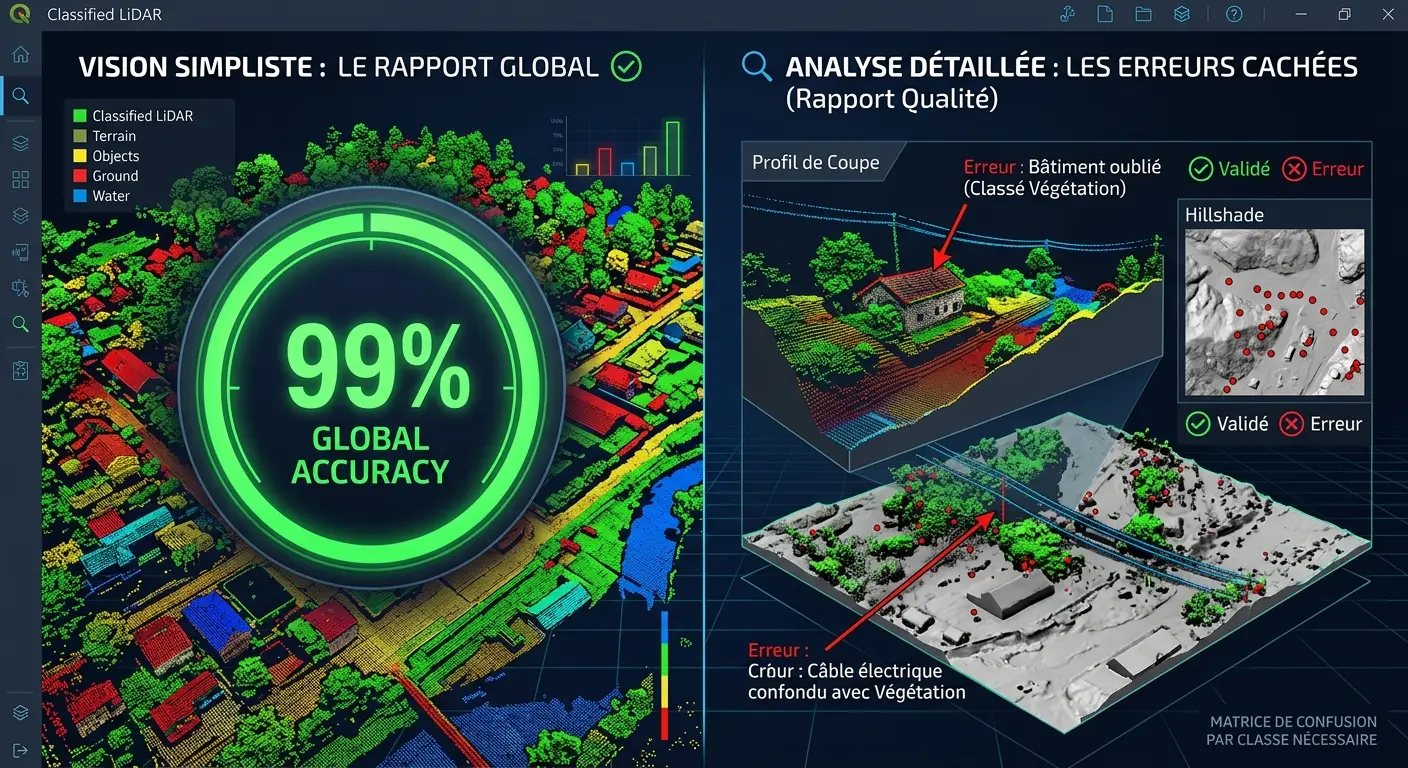
Quatre différences structurent ce problème en LiDAR aérien. Elles invalident un transfert direct des méthodes de l’imagerie. L’unité d’évaluation est un point et non un pixel, ce qui supprime la notion de grille régulière sur laquelle reposent les métriques matricielles. La densité est irrégulière, deux zones de même surface ne comportant pas le même nombre de points, ce qui pondère implicitement les zones denses dans tout indicateur global. La référence est coûteuse, une vérification manuelle demandant une navigation tridimensionnelle plutôt qu’un simple regard. Et les erreurs n’ont pas le même poids, un point de sol mal classé au milieu d’un champ n’ayant aucune conséquence quand le même point sous une ligne électrique en a de considérables. Une conséquence importante en découle. Un taux de points correctement classés, indicateur le plus naturel, est aussi le moins informatif, et sa valeur élevée est compatible avec un produit inutilisable.Pourquoi les indicateurs globaux trompent
Un mécanisme arithmétique explique cette insuffisance. Il mérite d’être exposé. Les classes majoritaires dominent le décompte. Dans un relevé rural, les points de sol et de végétation représentent l’essentiel du volume, ce qui fait qu’une classification parfaite du sol et une défaillance complète sur le bâti produisent un taux global excellent. Trois effets s’ensuivent directement. Les classes minoritaires disparaissent de l’indicateur, alors qu’elles portent souvent l’enjeu, conducteurs et ouvrages notamment. Les zones difficiles sont sous-représentées, l’essentiel du volume se trouvant dans les configurations faciles. Et l’amélioration d’un point critique se traduit par un gain imperceptible, ce qui décourage l’effort là où il compte. Une observation en découle pour un projet de LiDAR aérien. Cette insuffisance reproduit exactement celle que l’article consacré aux frontières a exposée pour l’imagerie, et elle appelle la même réponse, des métriques par classe et ciblées sur les configurations difficiles.Les métriques utiles
Cinq mesures renseignent réellement sur une classification de LiDAR aérien. Leur combinaison remplace utilement un indicateur unique. La matrice de confusion par classe, qui distingue quelles classes sont confondues avec quelles autres, information qu’aucun taux global ne fournit et qui oriente directement la correction. Le rappel et la précision par classe, séparément, une classe bien détectée mais surinterprétée et une classe rarement détectée mais fiable appelant des corrections opposées. Les taux mesurés sur les seules configurations difficiles, échantillonnées délibérément, qui renseignent sur ce que le produit vaut là où il est sollicité. L’écart sur les produits dérivés, différence altimétrique entre le modèle de terrain produit et une référence, métrique qui exprime la qualité dans l’unité qui intéresse l’utilisateur. Et le taux de points non classés, indicateur de complétude que les métriques de justesse ignorent.La question de la référence
Cette difficulté borne tout ce qui précède. Elle domine l’évaluation en LiDAR aérien. Établir la classe véritable d’un point demande un jugement humain, et ce jugement présente une variabilité que l’article consacré aux frontières a établie comme la borne de toute mesure. Trois sources de référence coexistent et leurs qualités diffèrent nettement. La réannotation par un expert sur un échantillon, méthode la plus fiable et la plus coûteuse, dont la représentativité dépend du plan d’échantillonnage. Les mesures de terrain, altitudes relevées par géomètre sur des points identifiés, référence absolue en altimétrie et ponctuelle par nature. Et les référentiels externes, cadastre ou base de bâtiments, qui fournissent une vérité partielle avec les écarts de date et de définition que les séries précédentes ont documentés. Une recommandation en découle. Mesurer le désaccord entre deux experts sur les configurations difficiles fournit la borne de performance atteignable, et ce chiffre permet de répondre à une exigence irréaliste par un fait plutôt que par une négociation.L’échantillonnage pour l’évaluation
Quatre principes gouvernent la constitution d’un échantillon. Leur omission produit un chiffre que rien ne soutient. La stratification par classe est nécessaire, un échantillon aléatoire de points ne contenant pratiquement aucun point des classes minoritaires. La stratification par configuration s’ajoute utilement, un échantillon comportant délibérément des zones difficiles renseignant mieux qu’un échantillon représentatif du volume. L’unité d’échantillonnage doit être choisie explicitement, échantillonner des points ou échantillonner des zones ne mesurant pas la même chose et l’unité zone étant généralement plus informative. Et la séparation géographique de l’entraînement est nécessaire lorsqu’un modèle est en jeu, deux zones voisines partageant trop de contexte. Une observation importante en découle. Un échantillon stratifié sur les configurations difficiles ne permet pas d’estimer une qualité globale, ce qui plaide pour une combinaison, un échantillon aléatoire léger fournissant l’estimation générale et un échantillon ciblé plus dense fournissant le diagnostic.Les modes d’erreur à suivre séparément
Six modes d’échec méritent d’être distingués car ils appellent des corrections différentes et un indicateur agrégé n’en révèle aucun. La confusion entre classes voisines, sol pris pour végétation basse ou l’inverse, erreur fréquente et de conséquence modérée. La confusion entre classes éloignées, végétation prise pour bâti, erreur plus rare et plus grave. L’omission d’objets entiers, un bâtiment ou un arbre non détecté, mode d’échec que les taux par point masquent puisqu’un petit objet représente peu de points. La fausse détection, un objet créé là où il n’y en a pas, généralement par regroupement abusif de points de bruit. Le défaut de délimitation, un objet correctement identifié dont les limites incluent ou excluent à tort des points voisins. Et l’incohérence spatiale, une même configuration classée différemment selon la zone, mode d’échec qui signale une convention insuffisante plutôt qu’une erreur individuelle. Une conséquence pratique en découle pour un projet de LiDAR aérien. Ce dernier mode est le plus informatif à suivre, sa présence indiquant qu’aucune correction individuelle ne résoudra le problème et qu’il faut reprendre le référentiel de cas.Le contrôle par produits dérivés
Cette méthode présente le meilleur rendement de toutes. Elle mérite d’être systématisée dans toute production de LiDAR aérien. Le principe consiste à générer un modèle de terrain et à l’examiner en ombrage, représentation qui rend les défauts de classification immédiatement visibles. Quatre signatures caractéristiques se lisent en quelques minutes. Une bosse signale un objet mal classé en sol, bâtiment ou véhicule le plus souvent. Un creux signale une absence de points sol, par occlusion ou par classification trop restrictive. Des ondulations régulières signalent un défaut d’ajustement entre bandes de vol, difficulté qui relève de l’acquisition. Et des hauteurs négatives dans le modèle de hauteur signalent une incohérence entre classes, situation physiquement impossible et donc diagnostique sans ambiguïté. Une conséquence pratique en découle pour un projet de LiDAR aérien. Ce contrôle coûte quelques minutes par lot, il ne demande aucun outillage particulier, et son omission explique une part importante des défauts qui atteignent les clients.Les contrôles automatiques de cohérence
Cinq vérifications se programment une fois. Elles s’exécutent ensuite sur tout un lot sans intervention. Les points de sol au dessus de points d’une autre classe à la même position planimétrique, configuration impossible. Les points isolés flottant loin de toute surface, généralement du bruit non filtré. Les hauteurs négatives dans le modèle dérivé, exposées plus haut. Les objets de taille aberrante, un bâtiment de quelques points ou un arbre de plusieurs centaines de mètres signalant une erreur de regroupement. Et les discontinuités aux limites de lots, un objet classé différemment de part et d’autre d’une frontière révélant une incohérence entre annotateurs. Une observation en découle. Ces cinq vérifications ne mesurent pas la justesse mais elles détectent l’impossible, ce qui en fait un filtre préalable dont le coût marginal est nul après le premier développement.Exprimer une exigence de qualité
Une formulation opérationnelle vaut mieux qu’un taux. Elle se construit en trois temps. Établir ce que l’erreur coûte à l’usage. Un point de sol manquant au milieu d’un champ ne coûte rien ; le même sous une ligne électrique peut coûter une coupure. Traduire ce coût en exigence sur les classes et les configurations qui comptent, plutôt qu’en taux global sur l’ensemble. Et vérifier que cette exigence dépasse le désaccord entre experts mesuré sur ces mêmes configurations, faute de quoi elle est irréalisable. Une conséquence pratique en découle. Une exigence formulée ainsi est vérifiable, elle protège les deux parties, et elle évite la situation où un prestataire atteint le taux contractuel tout en livrant un produit inadapté à l’usage.Le contrôle en cours de production
Quatre dispositifs distinguent un contrôle continu d’une vérification finale et ils évitent de découvrir un problème sur un volume déjà produit. Le contrôle du premier lot de chaque annotateur, examiné intégralement, qui révèle les malentendus de convention avant qu’ils ne se répètent. Le contrôle par échantillon sur chaque lot suivant, dont le taux peut décroître à mesure que la confiance s’établit. Le suivi d’indicateurs simples par lot, proportion de chaque classe et taux de points non classés, dont une valeur inhabituelle signale un lot atypique ou une dérive. Et les sessions de calibration périodiques, où plusieurs annotateurs traitent le même échantillon et confrontent leurs résultats. Une observation en découle pour un projet de LiDAR aérien. Le troisième dispositif est le moins coûteux et le plus négligé, un simple tableau de proportions par lot révélant une anomalie que personne n’aurait cherchée.Les erreurs les plus fréquentes
- Se fier à un taux global de points correctement classés.
- Négliger les classes minoritaires dans l’évaluation.
- Échantillonner aléatoirement sans stratifier par classe.
- Évaluer sur les configurations faciles qui dominent le volume.
- Ne pas mesurer le désaccord entre experts sur les cas difficiles.
- Omettre le contrôle par produit dérivé avant livraison.
- Confondre justesse et complétude en ignorant les points non classés.
- Employer un référentiel externe comme vérité sans mesurer son écart.
- Rapporter un rappel sans sa précision, ou l’inverse.
- Fixer une exigence en taux global plutôt que par classe et configuration.