La conduite autonome est le vertical qui a le plus structuré les pratiques d’annotation vidéo. Il a produit les jeux de référence, les formats et les métriques que d’autres domaines ont adoptés ensuite. Il présente aussi des contraintes qu’aucun autre secteur ne réunit.
Cet article expose ce que ce contexte exige et ce qu’il enseigne. Il prolonge l’article consacré à l’interpolation et aux keyframes.
Ce qui distingue ce contexte
Cinq propriétés le séparent des autres verticaux de l’annotation vidéo. Le point de vue est mobile, le véhicule porteur se déplaçant en même temps que les objets observés. Les capteurs sont multiples, caméras, radar et LiDAR fournissant des vues à recaler entre elles. La conséquence d’une erreur est corporelle, ce qui déplace l’exigence hors du champ économique. Les volumes sont considérables, une flotte de véhicules instrumentés produisant plus de données qu’aucune organisation ne peut annoter. Et le cadre réglementaire se construit, l’homologation de systèmes automatisés imposant des exigences de traçabilité inédites. Une conséquence pratique importante en découle. Ces cinq propriétés se cumulent, ce qui fait de ce vertical le plus exigeant de l’annotation vidéo et explique que ses pratiques se soient diffusées ailleurs.Ce que le point de vue mobile change
Cette propriété modifie plusieurs raisonnements des articles précédents. Tout objet paraît se déplacer dans l’image, y compris ceux qui sont immobiles au sol. Quatre conséquences en découlent. L’interpolation en repère image devient peu fiable, un objet fixe suivant une trajectoire apparente complexe. La distinction entre objet mobile et objet immobile n’est pas observable directement et constitue pourtant une information essentielle. Les occlusions deviennent fréquentes et brèves, le mouvement du porteur faisant passer des objets derrière d’autres en permanence. Et le changement d’échelle est rapide, un objet approché voyant sa taille varier fortement en peu d’images. Une observation importante en découle. La première conséquence justifie de travailler en repère absolu chaque fois que la trajectoire du porteur est connue, ce qui rétablit la régularité du mouvement et rend l’interpolation exploitable.Les objets à annoter
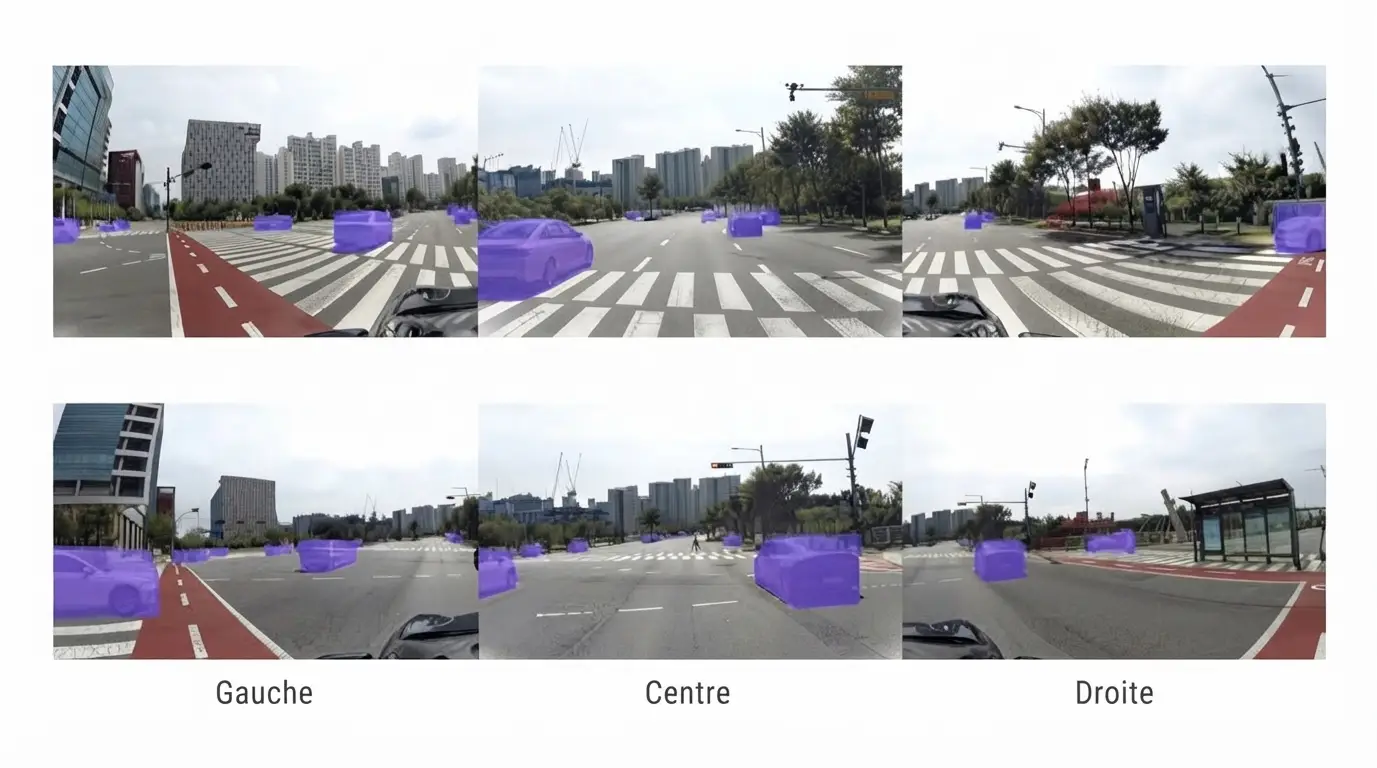
Cinq familles composent une nomenclature typique en annotation vidéo de conduite. Leurs exigences diffèrent. Les usagers vulnérables, piétons, cyclistes et deux-roues, classe critique dont l’omission a la conséquence la plus grave. Les véhicules, classe majoritaire dont la difficulté tient au volume plutôt qu’à la reconnaissance. Les éléments d’infrastructure, feux, panneaux et marquages, dont l’annotation demande souvent un attribut d’état. Les zones circulables, voies et bordures, qui relèvent d’une segmentation plutôt que d’une détection. Et les obstacles non catégorisés, objets présents sur la chaussée qui n’entrent dans aucune classe et qu’il faut néanmoins signaler. Une conséquence pratique en découle pour un projet d’annotation vidéo. La dernière famille est la plus difficile à définir et la plus importante pour la sécurité, un système ne reconnaissant que des classes connues étant aveugle à ce qui n’y figure pas.L’asymétrie des erreurs
Cette propriété gouverne toutes les décisions d’annotation vidéo de ce vertical. Une omission sur un usager vulnérable et une fausse détection sur un buisson n’ont aucune commune mesure. Trois conséquences en découlent. Le contrôle qualité doit être exhaustif sur la classe critique et par sondage ailleurs, répartition qui contredit un contrôle uniforme. Les métriques doivent être rapportées par classe, une performance globale noyant la classe la plus importante dans le volume des véhicules. Et la convention doit favoriser la sur-annotation en cas de doute, un objet incertain devant être signalé plutôt qu’écarté. Une observation en découle. Cette troisième conséquence inverse la pratique habituelle, où le doute conduit à ne pas annoter, et elle doit être écrite explicitement faute de quoi les annotateurs appliquent leur réflexe.Le recalage entre capteurs
Cette opération conditionne l’exploitation d’un corpus multicapteur. Une annotation produite sur une caméra doit correspondre au même objet dans le nuage de points. Quatre difficultés y contribuent. La synchronisation temporelle, des capteurs échantillonnant à des cadences différentes ne fournissant pas des vues du même instant. La calibration géométrique, dont une dérive déplace toutes les correspondances. Les champs de vue distincts, un objet visible par un capteur et non par l’autre posant la question de son annotation. Et les conditions dégradant inégalement les capteurs, la nuit affectant la caméra sans affecter le LiDAR. Une conséquence pratique importante en découle. La troisième difficulté demande une règle explicite, un projet devant décider si la vérité terrain est définie par un capteur de référence ou par l’union des observations, décision qui change la nature du corpus.Le problème du volume
Cette contrainte économique structure l’annotation vidéo de conduite plus que tout autre. Une flotte instrumentée produit un volume qu’aucun budget d’annotation ne couvre. Trois stratégies de sélection en découlent. La sélection par événement, qui retient les séquences contenant un freinage, une manœuvre d’évitement ou une reprise en main. La sélection par incertitude, qui retient les séquences où un modèle existant hésite, méthode qui concentre l’effort sur ce que le système ne maîtrise pas. Et la sélection par couverture, qui retient les séquences dont les conditions manquent au corpus, météo, heure et géographie. Une observation importante en découle pour un projet d’annotation vidéo. La deuxième stratégie est la plus efficace et elle suppose un modèle déjà déployé, ce qui la rend indisponible au démarrage et explique que les premiers corpus reposent sur les deux autres.Définir la classe fourre-tout
Une difficulté mérite un traitement séparé car elle est la moins bien résolue de ce vertical. Un obstacle qui n’appartient à aucune classe connue doit néanmoins être signalé. Trois formulations existent et elles ne produisent pas le même corpus. La classe ouverte, qui demande d’annoter tout objet susceptible d’entraver la circulation sans le catégoriser, formulation large dont la frontière avec le décor reste floue. Le critère dimensionnel, qui retient tout objet dépassant une taille sur la chaussée, règle applicable et qui laisse passer les objets plats et les objets bas. Et la segmentation d’espace libre, qui inverse le problème en délimitant ce qui est circulable plutôt qu’en énumérant les obstacles. Une observation importante en découle pour un projet d’annotation vidéo. La troisième formulation résout la difficulté par construction, puisqu’elle ne suppose aucune énumération, et elle coûte davantage en annotation tout en offrant la seule garantie de couvrir l’inattendu.Les cas rares comme enjeu central
Cette propriété distingue ce vertical de la plupart des applications de vision. La performance moyenne importe moins que le comportement dans les situations exceptionnelles. Trois conséquences en découlent. Un corpus représentatif de la conduite ordinaire ne prépare pas aux situations qui provoquent les accidents. Les cas rares doivent être recherchés délibérément plutôt qu’attendus, ce qui rejoint la logique exposée pour les espèces rares dans d’autres domaines. Et leur volume dans le corpus doit dépasser leur fréquence réelle, sur-représentation assumée et non biais à corriger. Une conséquence pratique s’ensuit. Cette troisième conséquence entre en tension avec l’évaluation, un jeu de test sur-représentant les cas rares ne mesurant pas la performance en conditions réelles, ce qui impose de maintenir deux jeux distincts.Les attributs qui accompagnent chaque objet
Cinq informations s’ajoutent fréquemment à la boîte et elles multiplient la charge. L’occlusion, dont le degré conditionne l’exploitabilité de l’objet. La troncature par le bord de l’image, distincte de l’occlusion. L’orientation, indispensable pour prévoir une trajectoire et non déductible d’une boîte alignée. L’état d’activité, un véhicule à l’arrêt et un véhicule stationné appelant des réactions différentes. Et l’intention observable, clignotant, feu stop ou direction du regard d’un piéton. Une observation en découle. Le dernier attribut est le plus coûteux et le plus déterminant pour l’anticipation, ce qui en fait un arbitrage de périmètre à poser explicitement plutôt qu’une extension implicite du travail.Ce que la traçabilité exige
Cette contrainte émergente touche directement les prestataires d’annotation vidéo. L’homologation d’un système automatisé suppose de documenter les données qui l’ont entraîné. Quatre exigences en découlent. La description du corpus, contenu, couverture et conditions représentées. La méthode d’annotation, conventions et dispositif de contrôle. La séparation vérifiable entre entraînement et évaluation. Et la déclaration des limites, situations que le corpus ne couvre pas. Une conséquence pratique importante en découle pour un projet d’annotation vidéo. Ces quatre exigences correspondent exactement aux pratiques que les séries précédentes recommandaient pour d’autres raisons, ce qui fait qu’un prestataire les appliquant déjà se trouve conforme sans effort d’adaptation.Ce que ce vertical a apporté aux autres
Quatre pratiques nées ici se sont diffusées dans toute l’annotation vidéo. Il vaut la peine de les nommer. La sur-annotation des classes critiques, principe transposable à tout domaine où les erreurs sont asymétriques. La sélection par incertitude, qui a remplacé l’échantillonnage aléatoire dans de nombreux contextes. Le double jeu d’évaluation, l’un représentatif et l’autre enrichi en cas difficiles. Et la documentation du corpus comme livrable, pratique que l’exigence réglementaire a rendue standard ici avant de se diffuser ailleurs. Une observation en découle. Ces quatre pratiques s’appliquent utilement à des projets bien plus modestes que la conduite autonome, et leur adoption ne suppose ni les volumes ni les budgets de ce vertical.Ce que ce contexte ne pardonne pas
Quatre défaillances d’annotation vidéo y ont une gravité qu’elles n’auraient pas ailleurs. Une convention d’occlusion non écrite, qui produit une incohérence sur la classe la plus critique. Un défaut de synchronisation entre capteurs, qui fausse silencieusement toutes les correspondances. Un corpus dont les conditions ne sont pas documentées, qui interdit d’établir le domaine d’emploi du système. Et une classe fourre-tout mal définie, qui laisse le système aveugle aux obstacles qu’il n’a jamais vus. Cette quatrième défaillance mérite d’être soulignée. Elle constitue la difficulté la moins bien traitée de ce vertical, définir ce qui n’entre dans aucune catégorie étant beaucoup plus difficile que définir les catégories elles-mêmes.Aborder un projet de ce type
Cinq questions cadrent ce type de projet et elles se posent en une réunion. Quels capteurs et quelle référence. Cette réponse détermine si la vérité terrain est définie par un capteur ou par l’union des observations. La trajectoire du porteur est-elle disponible. Cette réponse conditionne la possibilité de travailler en repère absolu. Quels attributs sont exigés. Cette réponse détermine la charge davantage que le nombre d’objets. Comment les séquences sont-elles sélectionnées. Cette réponse détermine la valeur du corpus plus que son volume. Et une documentation de traçabilité est-elle attendue. Cette réponse ajoute un livrable qui ne se reconstitue pas après coup. Ces cinq réponses déterminent le périmètre, la charge et les livrables. Les poser avant de commencer évite un corpus volumineux dont la couverture n’est pas établie.Ce que ce chapitre enseigne
Une observation transversale mérite de clore cet examen. Ce vertical a poussé l’annotation vidéo à ses limites et il en a tiré des pratiques transposables. Trois constats la composent. L’asymétrie des erreurs impose une répartition inégale de l’effort de contrôle, principe qui vaut partout où toutes les classes n’ont pas la même conséquence. La sélection des séquences détermine la valeur d’un corpus davantage que son volume, ce qui déplace l’enjeu de la production vers la conception. Et la documentation du corpus, imposée ici par l’homologation, correspond à ce que la réutilisation exige de toute façon. Ce constat rejoint celui que les séries précédentes ont établi dans des domaines sans rapport : les exigences réglementaires formalisent des pratiques qui étaient déjà rationnelles, et un prestataire les ayant adoptées par méthode se trouve conforme sans transition.Les erreurs les plus fréquentes
- Interpoler en repère image alors que la trajectoire du porteur est disponible.
- Rapporter une performance globale sans isoler les usagers vulnérables.
- Laisser la convention de doute à l’appréciation des annotateurs.
- Négliger la définition de la classe des obstacles non catégorisés.
- Ne pas trancher quel capteur définit la vérité terrain.
- Ignorer la synchronisation temporelle entre capteurs.
- Sélectionner les séquences au hasard plutôt que par événement ou par incertitude.
- Utiliser un jeu d’évaluation enrichi en cas rares pour mesurer la performance réelle.
- Ajouter des attributs d’intention sans en chiffrer la charge.
- Constituer un corpus sans documenter les conditions couvertes.