
Une étude récente a comparé onze outils libres calculant les mêmes métriques de distance sur les mêmes masques. Ses auteurs rapportent un résultat qu’ils qualifient eux-mêmes d’alarmant : des écarts de distance de Hausdorff dépassant 100 millimètres et plusieurs différences statistiquement significatives entre outils, démontrant qu’une amélioration statistiquement significative sur un même jeu de segmentations peut être obtenue simplement en choisissant une implémentation particulière.Autrement dit, sans toucher aux masques ni au modèle, changer de bibliothèque suffit à améliorer significativement un résultat publiable. Cette observation devrait suffire à disqualifier l’idée qu’une métrique est une mesure objective et transposable d’une étude à l’autre.Cet article traite de ce que mesurent réellement les métriques du domaine, de leurs propriétés respectives et des pièges de leur calcul et de leur agrégation. Il prolonge le guide complet de la segmentation d’images médicales.
Le problème de fond
Le cadre de référence le plus complet sur les métriques de segmentation d’images médicales pose un diagnostic sévère et utile : l’usage actuel des métriques est souvent mal informé et ne reflète pas l’intérêt sous-jacent du domaine.La raison tient à une inversion. Une métrique devrait être choisie à partir de la question clinique, chaque question appelant un indicateur différent. En pratique, elle est choisie par convention, le coefficient de Dice étant employé par défaut parce que tout le monde l’emploie, et la question clinique n’intervient jamais dans le raisonnement.Cette inversion a une conséquence directe sur un projet d’annotation. Le contrôle qualité d’un corpus utilise les mêmes métriques que l’évaluation d’un modèle, et il hérite donc des mêmes défauts. Un dispositif de contrôle fondé sur un indicateur inadapté valide des corpus médiocres et rejette des corpus corrects.Les deux familles de métriques de segmentation d’images médicales
Les indicateurs du domaine se répartissent en deux groupes qui mesurent des choses différentes, et le cadre de référence les traite d’ailleurs séparément.Les métriques de recouvrement
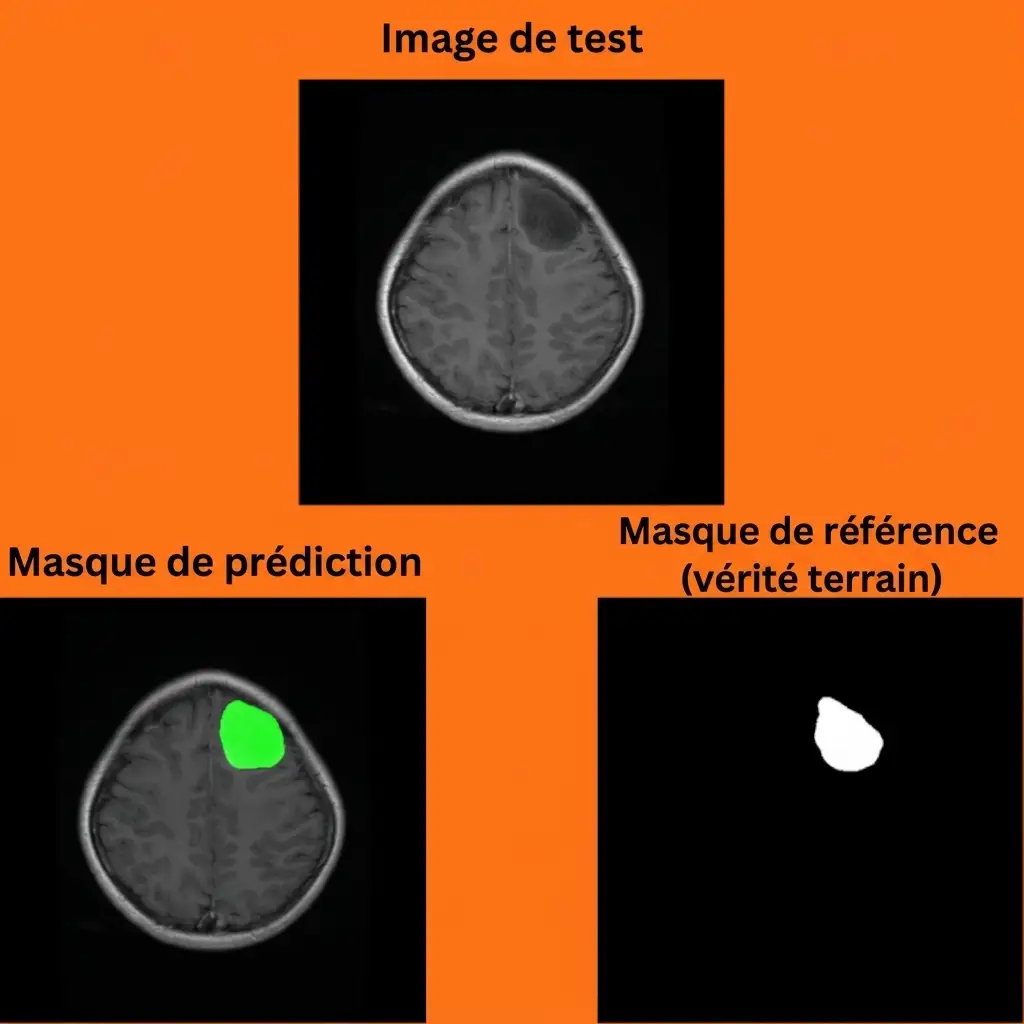
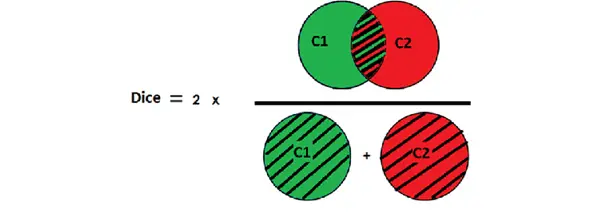
Elles comparent l’intersection de deux masques à leur union ou à leur somme. Le coefficient de Dice et l’indice de Jaccard en sont les représentants, et ils sont mathématiquement liés : l’un se déduit de l’autre, si bien que les rapporter tous les deux n’apporte aucune information.Leur propriété essentielle est d’être dominées par le volume. Sur une structure compacte, le cœur représente l’essentiel des voxels, et une erreur de frontière ne pèse que faiblement. Sur une structure fine, la frontière représente une part énorme du total, et le même écart absolu effondre le score.Cette propriété a deux conséquences. Comparer des structures de tailles différentes par le recouvrement n’a pas de sens, l’écart mesuré reflétant la géométrie autant que la difficulté. Et une frontière systématiquement décalée de un ou deux voxels, qui est l’erreur d’annotation la plus courante, reste presque invisible sur les grosses structures.Les métriques de distance
Elles mesurent l’écart géométrique entre les deux surfaces plutôt que le recouvrement des volumes. Le cadre de référence en recense plusieurs : la distance de surface symétrique moyenne, le recouvrement de frontière, la distance de Hausdorff, son 95e centile, la distance de surface moyenne et la distance de surface normalisée.Leur intérêt est de capturer ce que le recouvrement néglige : la localisation et l’amplitude de l’erreur maximale. Une segmentation peut afficher un excellent recouvrement tout en présentant une excroissance aberrante à un endroit, et seule une métrique de distance la révèle.Leur difficulté est double. Elles sont sensibles aux valeurs extrêmes, une seule composante isolée suffisant à dégrader la distance de Hausdorff brute, ce qui explique l’usage courant de son 95e centile. Et leur calcul est nettement plus complexe que celui du recouvrement, ce qui nous ramène au problème d’implémentation évoqué en introduction.La question qui décide
Le cadre de référence formule le critère de choix d’une manière remarquablement claire, et cette formulation vaut mieux qu’une liste de recommandations.Il indique que si les imprécisions d’annotation doivent être compensées, la recommandation par défaut est la distance de surface normalisée, et que sinon la préférence fondamentale guidant le choix d’une métrique est de savoir si les erreurs doivent être pénalisées par leur existence ou par leur distance.Cette alternative mérite d’être comprise, car elle correspond à une différence clinique réelle. Pénaliser par l’existence signifie que tout voxel mal classé compte, quelle que soit sa position : c’est ce que fait le recouvrement, et c’est adapté lorsque la grandeur recherchée est un volume. Pénaliser par la distance signifie qu’un voxel mal classé loin de la frontière compte plus qu’un voxel mal classé à un demi-millimètre : c’est ce que font les métriques de distance, et c’est adapté lorsque la position de la frontière importe, en planification thérapeutique par exemple.Un projet doit donc répondre à une question avant de choisir : ce qui compte est-il la quantité de matière ou la position de la limite. La réponse détermine la famille, et elle découle de l’usage clinique traité dans le guide général.La tolérance et son rôle
Une métrique mérite une attention particulière parce qu’elle répond directement à un problème que les autres ignorent : celui de l’imprécision d’annotation.La distance de surface normalisée mesure la proportion de frontière située à moins d’une distance donnée de la frontière de référence. Elle introduit donc explicitement une tolérance, en dessous de laquelle un écart n’est pas compté comme une erreur.Cette tolérance est ce qui la rend intéressante en contrôle de corpus. Puisque la référence humaine est elle-même imprécise, exiger une coïncidence exacte n’a pas de sens, et fixer une tolérance revient à dire explicitement à partir de quel écart on considère qu’il y a désaccord.Le choix de cette valeur est une décision clinique et non technique. Elle devrait correspondre à l’écart en dessous duquel la différence ne change aucune décision, ce qui suppose de poser la question au clinicien référent. Une tolérance choisie arbitrairement rend la métrique aussi conventionnelle que celles qu’elle remplace.Le piège de l’implémentation
Ce point est le plus important de l’article et le moins connu des équipes de segmentation d’images médicales.Une synthèse sur le sujet identifie l’origine du problème : la méthode employée pour extraire la frontière de segmentation, qui fait partie intégrante de toutes les métriques de distance, n’est pas unifiée entre les différents outils et peut donc influencer les scores obtenus.Le mécanisme est simple à comprendre. Avant de mesurer une distance entre deux surfaces, il faut définir ce qu’est la surface d’un masque composé de voxels. Plusieurs définitions sont possibles, chacune produisant une frontière légèrement différente, et l’écart se propage dans le calcul. S’y ajoutent des choix sur la prise en compte de l’espacement anisotrope et sur le traitement des bords du volume.Les écarts observés dépassent largement ce que l’intuition suggère, et l’étude citée en introduction conclut que les comparaisons entre études publiées sont douteuses dès lors qu’elles ne tiennent pas compte des différences d’implémentation.Trois conséquences pratiques s’imposent pour un projet. La bibliothèque de calcul doit être fixée, documentée et versionnée au même titre que le protocole. Un chiffre de performance annoncé sans mention de l’outil de calcul n’est pas comparable à un autre. Et tout changement de bibliothèque en cours de projet crée une rupture dans les séries de mesures, qu’il faut signaler plutôt que subir.L’agrégation, second piège
Une fois les métriques calculées par cas, il faut les résumer, et cette opération apparemment anodine change les conclusions.Deux ordres d’agrégation coexistent. La moyenne par cas puis par classe donne le même poids à chaque examen. La moyenne par classe puis par cas donne le même poids à chaque structure. Les deux produisent des chiffres différents dès que les classes ne sont pas également présentes, et la plupart des publications ne précisent pas laquelle a été employée.Une seconde question porte sur la pondération. Un score moyen sur un corpus multi-structures est dominé par les structures volumineuses, qui obtiennent mécaniquement de meilleurs recouvrements. Un foie et une lésion millimétrique ne devraient jamais figurer dans la même moyenne.Une troisième porte sur la dispersion. Rapporter une moyenne sans son écart-type ni ses valeurs extrêmes masque exactement ce qui intéresse en contrôle qualité : les cas qui échouent. Un corpus à 0,90 de moyenne avec quelques cas à 0,30 n’est pas équivalent à un corpus uniformément à 0,90, et seul le second est exploitable.Le cas vide
Une situation particulière produit des résultats absurdes et se rencontre sur tous les corpus lésionnels.Lorsqu’une structure est absente d’un examen, la référence est vide. Le recouvrement n’est alors pas défini, et selon la convention retenue le cas est compté comme parfait, comme nul, ou exclu. Les trois choix produisent des moyennes très différentes.Le problème est plus grave qu’il n’y paraît, car la bonne réponse dépend de la prédiction. Si le modèle ne prédit rien non plus, il a raison et devrait être crédité. S’il prédit une structure inexistante, il se trompe gravement et le recouvrement de zéro ne traduit pas l’ampleur de l’erreur, puisqu’un faux positif de dix voxels et un de dix mille voxels obtiennent le même score.La convention doit donc être écrite, et elle gagne à être complétée par un indicateur séparé comptant les cas où une structure absente a été prédite et inversement. Ces deux comptages sont plus informatifs que n’importe quelle moyenne sur ces situations.Les métriques structurelles en segmentation d’images médicales
Une troisième famille, moins employée, répond à des questions que ni le recouvrement ni la distance ne traitent.Le comptage d’instances mesure combien d’objets ont été trouvés, indépendamment de leur délimitation. Il est indispensable dès que la décision clinique repose sur un nombre, lésions multiples ou dénombrement.La connexité mesure si une structure continue a été produite d’un seul tenant ou fragmentée. Elle est décisive sur les structures allongées, vaisseaux, voies aériennes ou fissures, où une segmentation fragmentée peut afficher un recouvrement honorable tout en étant inutilisable pour toute analyse de trajet. Le cadre de référence recense d’ailleurs une variante du coefficient de Dice conçue pour les structures tubulaires.L’erreur de mesure, enfin, compare directement la grandeur qui entre dans la décision clinique, volume ou longueur. C’est l’indicateur le plus directement interprétable par un clinicien, et le plus rarement rapporté.Ce que le contrôle qualité d’un corpus exige
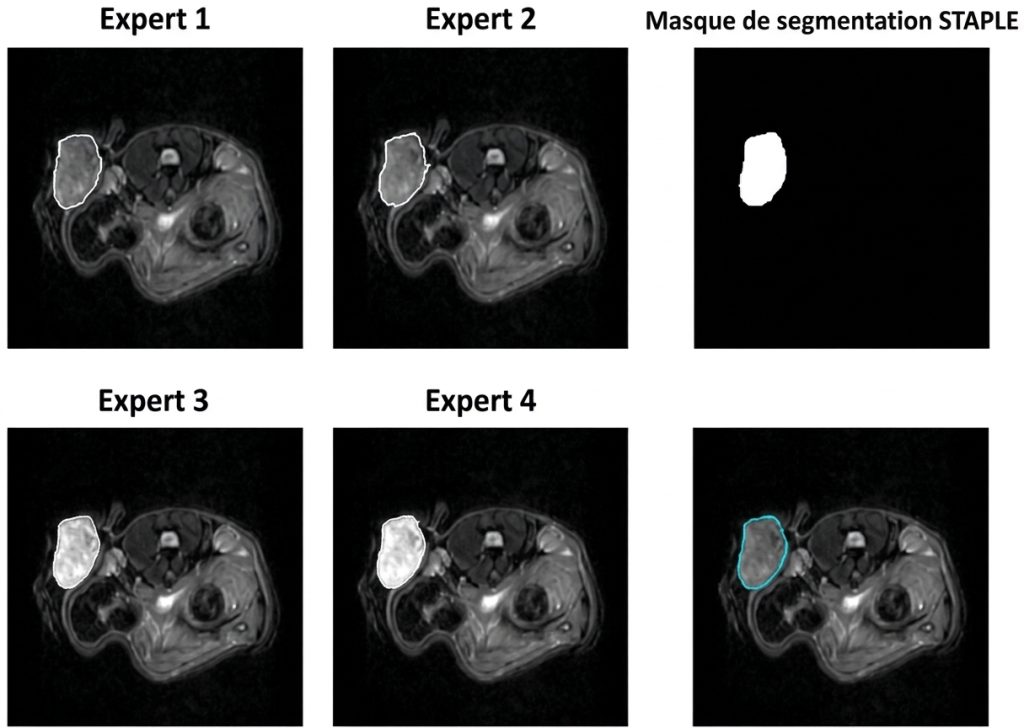
Les métriques de segmentation d’images médicales servent à deux usages distincts qu’il faut séparer : évaluer un modèle et contrôler un corpus. Le second a des exigences propres.La première est de mesurer l’accord entre annotateurs plutôt que la conformité à une référence, puisque en contrôle de corpus il n’existe pas de vérité indépendante. Les mêmes indicateurs s’appliquent, mais leur interprétation change : un accord de 0,85 entre deux annotateurs ne dit pas qu’ils sont bons, il dit qu’ils sont cohérents.La deuxième est de rapporter par annotateur autant que par classe, ce qui permet de distinguer une difficulté intrinsèque d’une dérive individuelle. Un accord faible sur une classe pour tous les annotateurs signale un problème de protocole ; un accord faible pour un seul annotateur signale un besoin de formation.La troisième est de suivre l’évolution dans le temps. Une métrique mesurée une fois en fin de projet ne sert à rien ; mesurée par lot, elle détecte les dérives quand elles sont encore corrigeables.Le seuil d’acceptation
Une question suit inévitablement le choix des métriques de segmentation d’images médicales et reçoit rarement une réponse motivée : à partir de quelle valeur un livrable est-il accepté.Trois façons de fixer ce seuil coexistent, et elles ne se valent pas. Le seuil par convention reprend une valeur courante dans la littérature, ce qui est commode et sans fondement, puisque cette valeur a été obtenue sur d’autres structures et d’autres données. Le seuil par référence humaine s’aligne sur l’accord inter-experts mesuré au pilote, ce qui est défendable mais suppose que cette mesure ait été faite. Le seuil par conséquence part de l’écart en dessous duquel la décision clinique ne change pas, ce qui est le plus juste et le plus difficile à établir.La démarche recommandée combine les deux dernières. On mesure la borne humaine au pilote, on demande au clinicien à partir de quel écart la différence compte, et le seuil retenu se situe entre les deux. Un seuil supérieur à la borne humaine est intenable ; un seuil très inférieur au seuil de conséquence fait payer une précision qui ne sert à rien.Un point mérite d’être ajouté : le seuil doit être fixé par structure et non globalement, pour les raisons de géométrie déjà exposées. Un seuil unique appliqué à un foie et à une petite lésion revient à exiger deux niveaux de qualité très différents sans le dire.Comment rapporter
La forme de restitution détermine l’utilité des chiffres autant que leur exactitude.Quatre éléments constituent un rapport exploitable. Un couple de métriques, recouvrement et distance, plutôt qu’un indicateur unique, puisqu’ils mesurent des propriétés différentes et qu’un seul ne suffit jamais. Une ventilation par classe et par condition, jamais un chiffre global. La dispersion, écart-type et pires cas, en plus de la moyenne. Et la mention explicite de la bibliothèque de calcul et de sa version.Un cinquième élément améliore considérablement l’utilité pour un lecteur clinicien : la traduction en grandeur physique. Un écart de frontière exprimé en millimètres parle immédiatement, là où un coefficient sans dimension ne déclenche aucune intuition. Faire cette conversion coûte peu et transforme une restitution technique en aide à la décision.La borne à laquelle comparer
Un dernier point conditionne l’interprétation de tout chiffre produit.Une valeur de métrique n’a de sens que rapportée à une référence. Comparée à un idéal théorique, une performance de 0,85 paraît médiocre. Comparée à l’accord entre deux experts sur la même structure, elle peut être excellente.Cette borne se mesure au lot pilote, structure par structure, et elle est l’information la plus utile qu’un projet puisse produire sur son propre corpus. Elle détermine ce qui est atteignable, elle permet de situer honnêtement une performance, et elle évite de contractualiser un objectif que la variabilité humaine rend impossible.Les métriques ne remplacent pas le regard
Un contrepoint s’impose en segmentation d’images médicales, car la sophistication métrique peut devenir une façon de ne pas regarder les images.Aucune combinaison d’indicateurs ne détecte certaines erreurs. Une structure correctement délimitée mais mal étiquetée obtient un recouvrement nul sur deux classes sans que rien n’indique qu’il s’agit d’une permutation. Une segmentation systématiquement décalée dans une direction produit des chiffres corrects et une erreur constante. Et un masque parfait sur une image dont la géométrie a été altérée reste parfait au calcul et faux dans le référentiel patient.La relecture visuelle, dans les trois plans et sur un échantillon stratifié, reste donc indispensable et ne se remplace pas. Le rôle des métriques est de dire où regarder, non de dispenser de regarder.Une pratique simple exploite cette complémentarité : trier les cas par valeur de métrique et examiner systématiquement les pires, plutôt que tirer au hasard. Les cas extrêmes concentrent l’information, et ils révèlent fréquemment un défaut de protocole plutôt qu’une erreur individuelle, ce qui est l’information la plus utile qu’un contrôle puisse produire.Les erreurs les plus fréquentes
- Rapporter un coefficient de recouvrement sans mentionner la bibliothèque de calcul employée.
- Comparer des chiffres issus d’études ou d’outils différents sans vérifier les implémentations.
- Changer de bibliothèque en cours de projet sans signaler la rupture de série.
- Rapporter à la fois Dice et Jaccard, qui se déduisent l’un de l’autre.
- Comparer des structures de tailles très différentes par le seul recouvrement.
- Ne pas écrire la convention de traitement des cas où la structure est absente.
- Ne pas préciser l’ordre d’agrégation employé.
- Rapporter une moyenne sans dispersion ni pires cas.
- Choisir une tolérance de distance arbitrairement plutôt qu’avec le clinicien.
- Interpréter un chiffre sans l’avoir comparé à la borne d’accord inter-experts.