
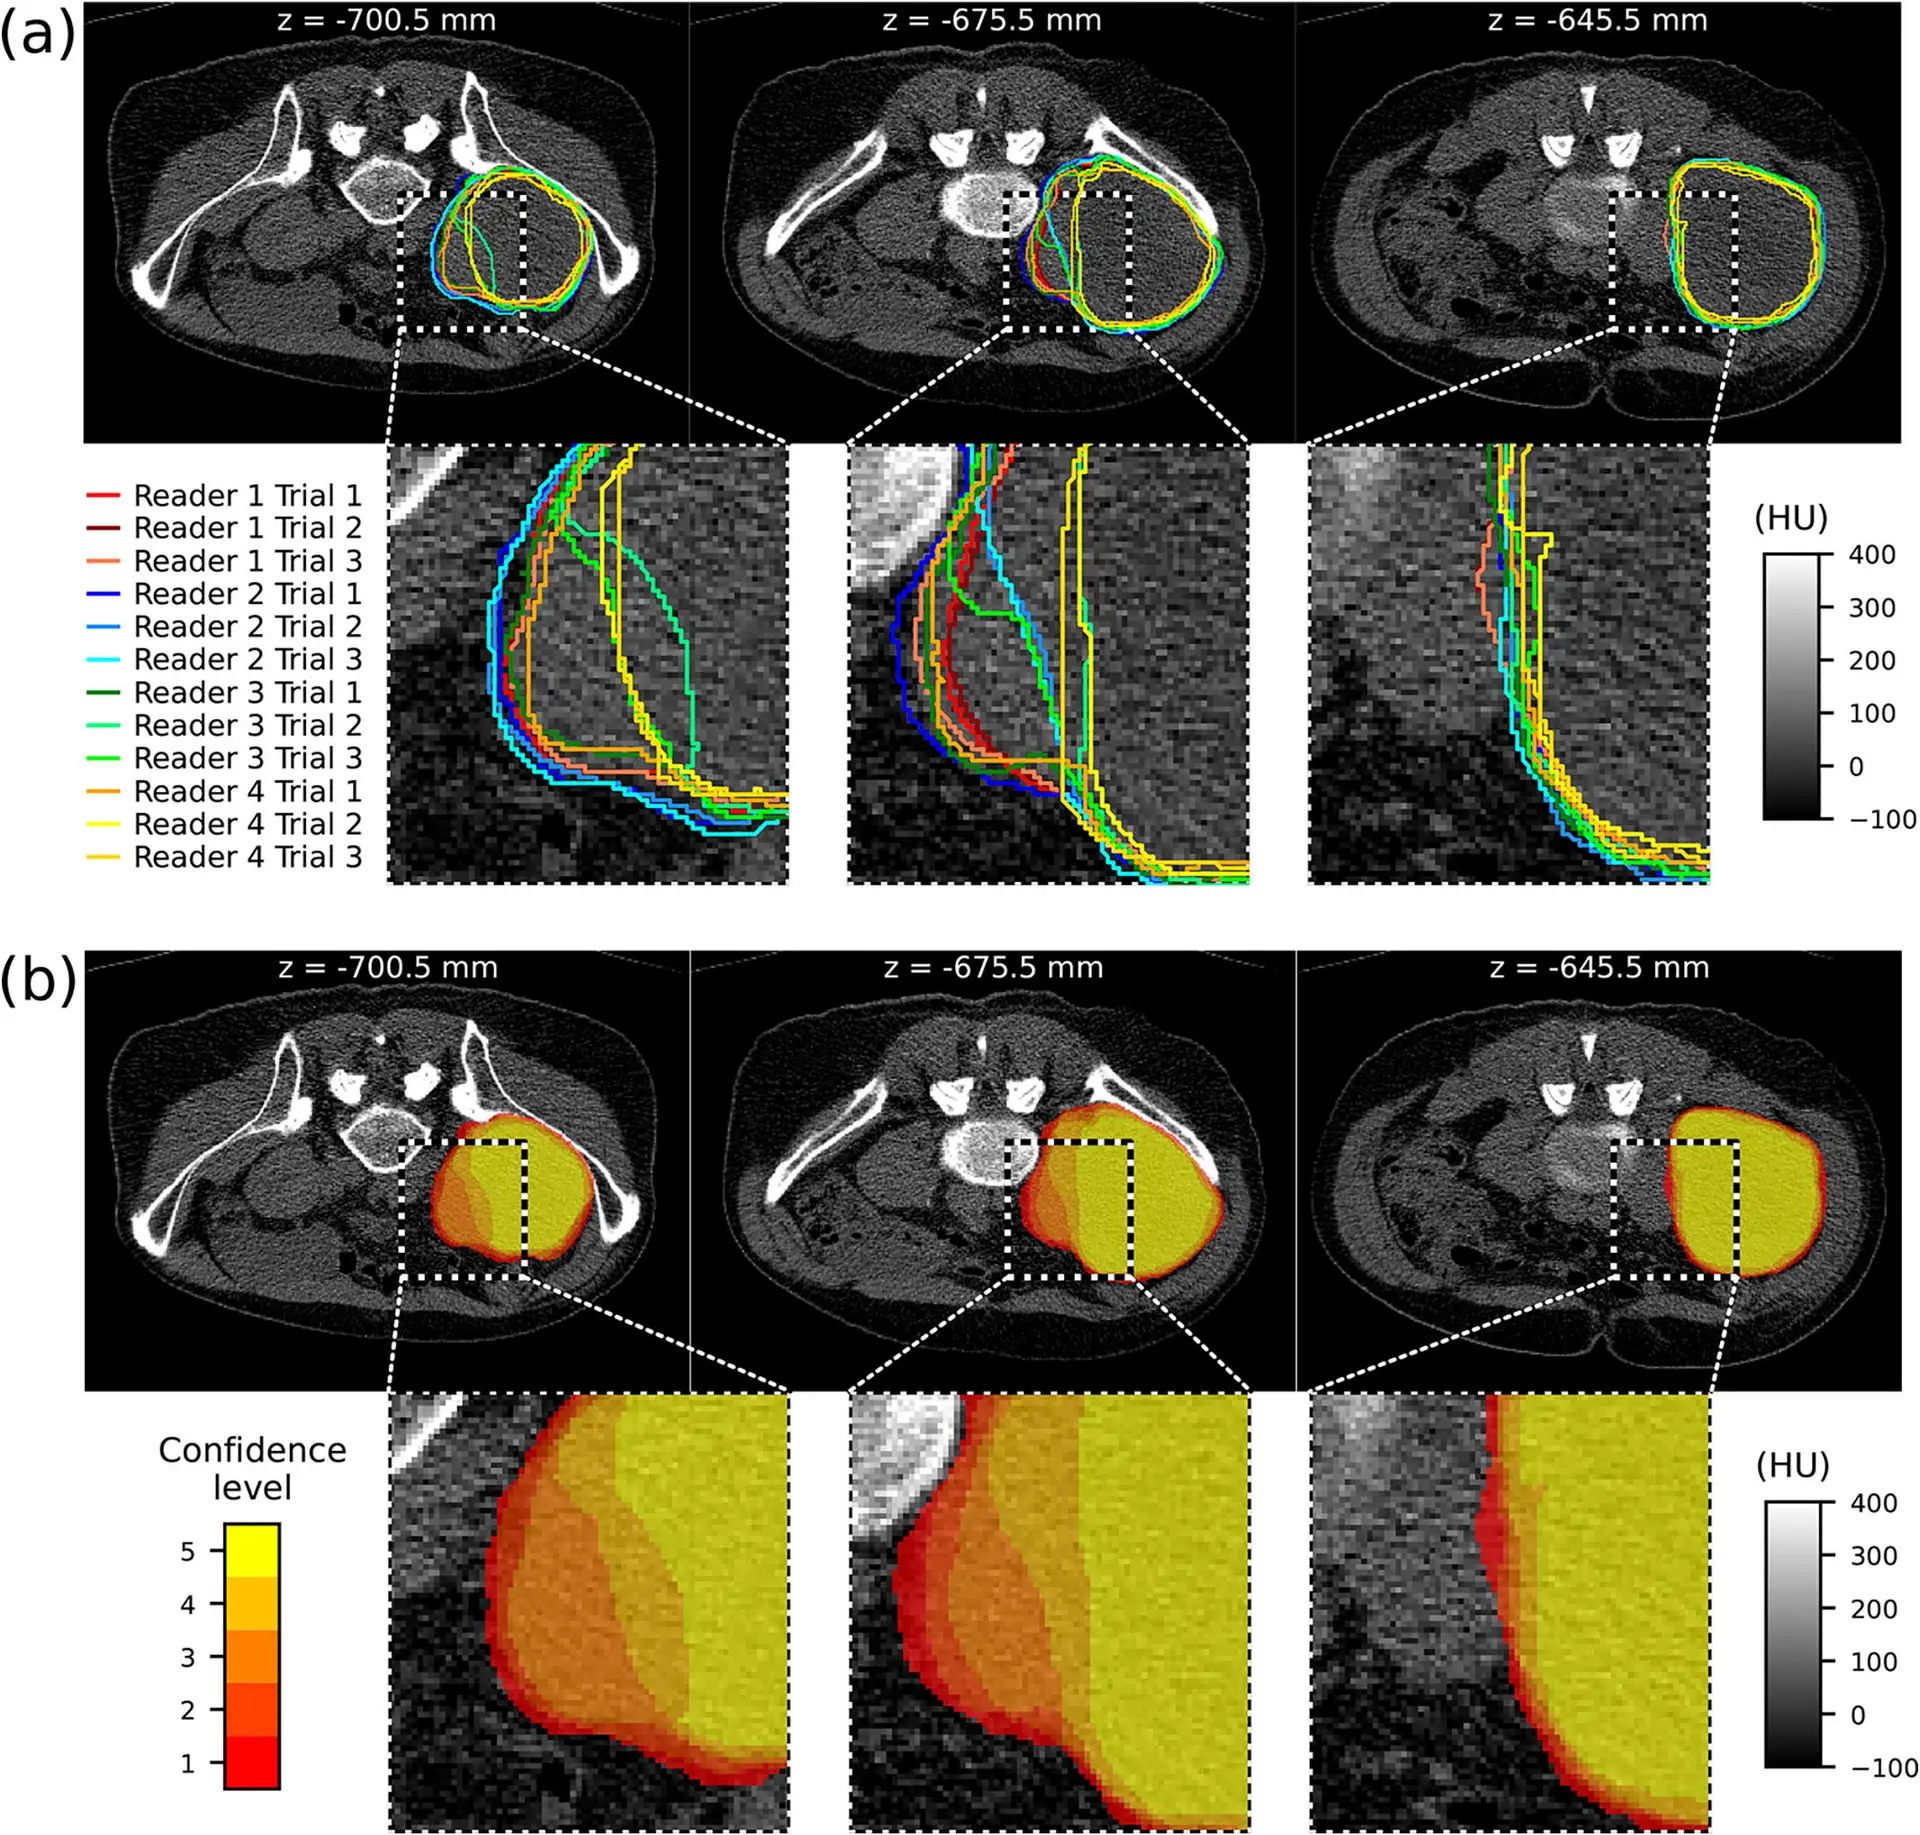
Une publication récente formule en une phrase ce que la plupart des projets refusent d’admettre : cette variabilité rend intenable la notion d’une vérité terrain unique et définitive.
La conséquence est inconfortable. Un corpus n’est pas la transcription d’une réalité que les annotateurs approcheraient plus ou moins bien : c’est le produit d’un accord partiel entre des lectures légitimement différentes. Traiter la variabilité comme un défaut à supprimer conduit alors à supprimer de l’information plutôt que du bruit.
Cet article traite de cette question sous l’angle d’un projet : d’où vient la variabilité, ce qui est réductible, comment la mesurer, et que faire des annotations multiples lorsqu’on en dispose. Il prolonge le guide complet de la segmentation d’images médicales.
Les trois sources de variabilité en segmentation d’images médicales
Une étude consacrée à la représentation de l’incertitude inter-annotateurs identifie l’origine du phénomène avec une utile concision : les tâches médicales sont sujettes à la variabilité inter-annotateurs en raison de multiples facteurs tels que la qualité de l’image, l’expérience et la formation professionnelles, ou la clarté des consignes. Ces trois sources n’appellent pas les mêmes réponses, et les confondre conduit à investir au mauvais endroit.La qualité de l’image
C’est la source irréductible par le protocole. Lorsque la frontière n’est pas visible, deux lecteurs produisent des limites différentes parce que l’information manque, non parce qu’ils divergent. Aucune formation ne corrige cela, et l’exiger revient à demander à l’annotateur d’inventer. La réponse est en amont, dans les critères d’acquisition et dans une classe de rejet explicite. Un projet qui accepte n’importe quelle qualité d’image hérite d’une variabilité qu’il attribuera ensuite à ses annotateurs.L’expérience et la formation
C’est la source la plus réductible, et celle sur laquelle un prestataire agit directement. Elle se traite par la formation initiale, le référentiel de cas commentés, les sessions de calibration et le contrôle par comparaison à une référence experte. Sa particularité est de produire une variabilité asymétrique : un annotateur moins formé n’est pas simplement plus dispersé, il est biaisé dans une direction, ce qui la rend détectable par comparaison mais invisible dans une mesure d’accord global entre pairs.La clarté des consignes
C’est la source la plus fréquente et la plus mal diagnostiquée. Lorsque deux annotateurs compétents, travaillant sur une image nette, produisent des limites différentes, la cause est presque toujours une règle absente ou ambiguë plutôt qu’une défaillance individuelle. Le symptôme est reconnaissable : le désaccord est systématique et non aléatoire, chaque annotateur étant cohérent avec lui-même mais appliquant une convention différente. Ce diagnostic est important car il oriente vers la révision du protocole plutôt que vers la formation, et ces deux réponses n’ont ni le même coût ni le même effet.Mesurer avant de réduire
La première erreur d’un projet de segmentation d’images médicales consiste à tenter de réduire la variabilité sans l’avoir caractérisée. La mesure utile ne se résume jamais à un coefficient d’accord global. Elle comporte trois volets. La ventilation par structure, puisque l’accord sur un organe compact et sur une lésion infiltrante n’ont aucun rapport et que leur moyenne ne décrit ni l’un ni l’autre. La ventilation par annotateur, qui distingue une difficulté partagée d’une dérive individuelle. Et l’examen des cas de désaccord maximal, qui contient l’essentiel de l’information diagnostique. Ce dernier point mérite insistance. Trier les cas par accord croissant et examiner les dix pires révèle en une heure ce qu’aucune statistique ne montre : si les désaccords portent tous sur le même type de situation, le protocole est en cause ; s’ils sont dispersés, la cause est individuelle ou liée à la qualité d’image. Cette mesure se fait au lot pilote et se répète par lot ensuite. Mesurée une fois en fin de projet, elle ne sert qu’à constater.Les stratégies de fusion d’annotations
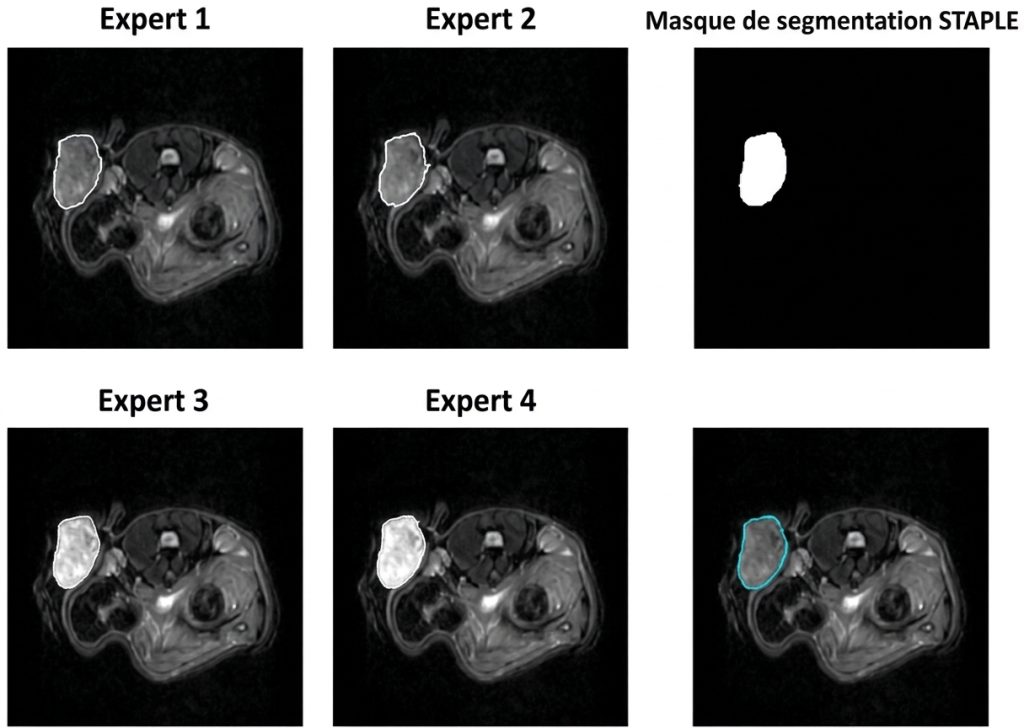
Lorsqu’on dispose de plusieurs annotations d’un même examen, il faut décider ce qu’on en fait, et plusieurs approches coexistent. Le vote majoritaire retient, pour chaque voxel, l’étiquette donnée par la majorité des annotateurs. Simple et robuste, il traite tous les annotateurs comme équivalents. L’estimation simultanée de vérité et de performance procède différemment : elle estime itérativement une segmentation de vérité latente tout en modélisant la sensibilité et la spécificité propres à chaque annotateur. Elle pondère donc implicitement les annotateurs selon leur fiabilité estimée, ce qui la rend supérieure lorsque les niveaux sont hétérogènes. La moyenne des annotations produit une carte continue plutôt qu’un masque binaire, conservant l’information de désaccord sous forme de valeurs intermédiaires. L’échantillonnage aléatoire, enfin, ne fusionne pas : il présente au modèle une annotation différente à chaque passage. Ces méthodes reposent sur une hypothèse qu’il vaut la peine d’expliciter. La même source note que l’approche par estimation de performance suppose qu’une segmentation vraie sous-jacente existe mais est masquée par les biais individuels. Cette hypothèse est raisonnable sur une structure anatomique bien définie et discutable sur une lésion à frontière conventionnelle, où le désaccord ne masque pas une vérité mais reflète une ambiguïté réelle.Ce que la fusion détruit
Une critique récurrente de ces méthodes mérite d’être connue, car elle change la façon de concevoir un corpus. Une étude sur l’apprentissage à partir d’annotations multi-sources la formule ainsi : l’information de variabilité inter-observateurs, qui représente la part commune et la part variable entre annotations de sources multiples, est négligée durant le processus de fusion. Autrement dit, produire un masque unique à partir de plusieurs annotations revient à jeter la seule information qui indique où le corpus est fiable et où il ne l’est pas. Cette information a une valeur propre : elle permet de pondérer l’entraînement, de calibrer les prédictions et de signaler à un utilisateur clinique les zones où le système est incertain pour de bonnes raisons. Une étude comparant les méthodes de fusion observe d’ailleurs que le cadre d’entraînement conventionnel présente une surconfiance et une sous-estimation de la variabilité inter-annotateurs, alors que les approches préservant cette variabilité produisent des modèles mieux calibrés. La conséquence pratique pour un projet d’annotation est de livrer, lorsque plusieurs annotations existent, à la fois le masque fusionné et les annotations individuelles. Le surcoût de stockage est négligeable et l’information perdue est irrécupérable.Le résultat contre-intuitif
Une observation mérite d’être connue avant d’investir dans un dispositif de fusion sophistiqué. Une étude portant sur l’effet de la variabilité inter-observateurs relève que l’entraînement avec l’ensemble de l’information étiquetée, c’est-à-dire sans fusion, obtient d’aussi bons résultats que l’entraînement avec vote majoritaire ou avec estimation de performance. Une seconde étude aboutit à une conclusion cohérente sur le choix de la méthode : aucune observation constante n’a été faite à travers les jeux de données permettant de déterminer une meilleure méthode de fusion globale. Deux enseignements pour un projet. D’abord, le choix de la méthode de fusion n’est pas la décision structurante qu’on suppose : les écarts de performance entre méthodes sont faibles et dépendants du jeu de données. Ensuite, l’effort gagne à porter sur la qualité et la cohérence des annotations elles-mêmes plutôt que sur la sophistication de leur agrégation, ce qui est une bonne nouvelle pour un prestataire d’annotation et une moins bonne pour les projets qui espèrent qu’un traitement statistique compensera un protocole faible.Réduire la variabilité en segmentation d’images médicales
Quatre leviers agissent réellement sur la variabilité en segmentation d’images médicales, et ils se distinguent par leur coût et par la source qu’ils traitent. Le premier est l’écriture des conventions. Chaque désaccord systématique observé au pilote désigne une règle manquante, et l’écrire supprime cette source pour toute la suite du projet. C’est le levier le moins coûteux et le plus efficace, et il agit sur la clarté des consignes. Le deuxième est le référentiel de cas commentés, qui transmet ce qu’aucune règle abstraite ne transmet. Sa valeur tient à ce qu’il documente la raison de chaque décision et non seulement la décision, ce qui permet de généraliser au cas suivant qui diffère légèrement. Le troisième est la session de calibration collective : faire annoter le même lot par toute l’équipe, puis discuter les écarts en présence du référent clinique. Elle transmet en une demi-journée ce qu’un document ne transmet pas, et elle se répète périodiquement car la dérive revient. Le quatrième est le contrôle par comparaison à une référence experte plutôt que par accord entre pairs. Ce point est décisif et souvent négligé : un groupe cohérent peut être cohéremment faux, et seule la comparaison à un expert révèle un biais partagé.La variabilité intra-annotateur
Une dimension de la variabilité est régulièrement oubliée alors qu’elle est plus facile à mesurer que la précédente. Un même annotateur, confronté deux fois au même examen à quelques semaines d’intervalle, ne produit pas la même annotation. Cette variabilité intra-annotateur constitue un plancher : personne ne peut être plus cohérent avec autrui qu’avec soi-même. Sa mesure est simple et peu coûteuse : réinjecter discrètement quelques examens déjà traités dans la file de travail et comparer. Elle apporte trois informations. Un plancher de cohérence contre lequel situer l’accord entre annotateurs. Un indicateur de dérive individuelle, qui progresse sur les tâches longues et répétitives. Et un signal de protocole, un annotateur en désaccord avec lui-même indiquant presque toujours une convention insuffisamment définie plutôt qu’un manque d’attention. Ce dernier point est le plus utile en pratique. Là où le désaccord entre deux personnes peut toujours s’attribuer à leurs différences, le désaccord d’une personne avec elle-même ne le peut pas, ce qui en fait un diagnostic de protocole particulièrement fiable.Combien d’annotateurs par examen
La question du nombre d’annotations par examen revient sur tous les projets et n’a pas de réponse uniforme. Trois régimes d’annotation se rencontrent en pratique. L’annotation simple avec contrôle par échantillon est le régime par défaut, économique et suffisant sur les structures à faible variabilité. La double annotation avec arbitrage double le coût et se justifie sur les structures dont la variabilité mesurée au pilote est élevée. L’annotation multiple, à trois annotateurs ou plus, coûte davantage encore et ne se justifie que sur les corpus d’évaluation ou sur les structures les plus ambiguës. La stratégie économiquement rationnelle est différenciée plutôt qu’uniforme. Appliquer la double annotation partout revient à payer un contrôle inutile sur les organes faciles et insuffisant sur les lésions difficiles. Le pilote fournit exactement l’information nécessaire à cette différenciation, et c’est l’un de ses apports les plus rentables. Un cas mérite une règle à part : le corpus d’évaluation. Puisqu’il sert à mesurer, sa qualité conditionne toutes les conclusions du projet, et l’annotation multiple s’y justifie même lorsqu’elle ne se justifie pas sur le corpus d’entraînement.La variabilité comme information livrable
Une conséquence des sections précédentes mérite d’être poussée jusqu’à sa forme pratique : ce qui est mesuré peut être livré. Un corpus accompagné de sa carte de variabilité vaut davantage qu’un corpus livré seul, et le surcoût est marginal dès lors que la mesure a été faite. Trois éléments composent cette livraison. Les annotations individuelles conservées à côté du masque de référence. Une carte de désaccord par examen, indiquant où les annotateurs ont divergé. Et une synthèse par structure des niveaux d’accord observés. Cette information sert trois usages en aval. Elle permet de pondérer l’entraînement, en accordant moins de poids aux régions ambiguës. Elle fournit une référence pour interpréter la performance du modèle, puisqu’un modèle qui échoue là où les experts divergent n’échoue pas au même titre qu’un modèle qui échoue là où ils s’accordent. Et elle constitue une pièce de la démonstration de qualité des données dans un contexte régulé. Peu de prestataires livrent cette information, principalement parce qu’elle expose une variabilité qu’il paraît préférable de taire. C’est un calcul à courte vue : elle sera découverte de toute façon, et l’avoir documentée soi-même la transforme d’aveu en méthode.Ce que le client doit comprendre
Cette question est le principal sujet de malentendu entre un prestataire de segmentation d’images médicales et son client, et l’aborder tôt évite des difficultés tardives. Trois points gagnent à être posés explicitement au cadrage. La variabilité existe entre les experts du client eux-mêmes, et la mesurer au pilote établit ce fait de façon neutre plutôt que défensive. Un objectif de qualité supérieur à cette borne est intenable par construction, quel que soit le prestataire. Et une part du désaccord ne sera pas réduite, parce qu’elle vient de l’image ou de l’ambiguïté de l’objet plutôt que du travail. Poser ces trois points avant la production plutôt qu’au moment d’une contestation change entièrement la nature de la discussion. Mesurée d’emblée, la variabilité devient une donnée partagée du projet ; découverte tardivement, elle ressemble à une excuse.Le coût de la variabilité
La variabilité a un coût qui apparaît dans plusieurs postes d’un projet de segmentation d’images médicales et gagne à être identifié comme tel. Le premier est le dispositif de mesure, mobilisant du temps d’annotateur sur des cas dupliqués et du temps d’expert sur les références. Le deuxième est la double annotation là où elle est retenue. Le troisième est l’arbitrage, qui mobilise le référent clinique et dont le volume dépend directement du niveau de variabilité résiduelle. Le quatrième, le plus important et le moins visible, est la révision du protocole en cours de projet, qui impose parfois de reprendre des lots déjà livrés. Ce dernier poste justifie à lui seul d’investir dans un pilote sérieux. Une convention manquante détectée sur cinquante examens coûte une réécriture ; détectée sur cinq mille, elle coûte une reprise.L’effet de l’assistance automatique
Un phénomène récent modifie le paysage de la variabilité en segmentation d’images médicales et mérite d’être anticipé plutôt que constaté. La pré-annotation automatique réduit mécaniquement la variabilité entre annotateurs, puisqu’ils partent tous du même masque. Cette réduction est réelle et mesurable, et elle est fréquemment présentée comme un gain de qualité. Elle n’en est pas nécessairement un. Un accord élevé obtenu par ancrage sur une proposition commune ne signifie pas que les annotateurs voient la même chose, mais qu’ils ont tous accepté la même suggestion. Si cette suggestion est biaisée, le corpus l’est uniformément, et l’indicateur d’accord ne le signale pas. Deux mesures permettent de distinguer les deux situations. Faire annoter sans assistance une fraction du corpus et comparer les deux populations, sur la taille des structures et sur la position des frontières. Et mesurer l’accord entre annotateurs assistés et référence experte plutôt qu’entre eux, ce qui reste le seul moyen de détecter un biais partagé. Cette précaution devient plus importante à mesure que la qualité des modèles progresse, puisque l’ancrage croît avec la plausibilité de la proposition. Un projet de segmentation d’images médicales fortement assisté doit donc renforcer son dispositif de comparaison à une référence, non l’alléger sous prétexte que l’accord s’améliore.Les erreurs les plus fréquentes
- Traiter la variabilité comme un défaut d’annotateur sans avoir diagnostiqué sa source.
- Fixer un objectif de qualité sans avoir mesuré la borne inter-experts.
- Mesurer l’accord globalement plutôt que par structure et par annotateur.
- Contrôler par accord entre pairs sans comparaison à une référence experte.
- Livrer uniquement le masque fusionné en supprimant les annotations individuelles.
- Investir dans une méthode de fusion sophistiquée plutôt que dans la qualité du protocole.
- Négliger la mesure de variabilité intra-annotateur, plus simple et très informative.
- Appliquer un régime d’annotation multiple uniforme plutôt que différencié.
- Traiter le corpus d’évaluation avec le même régime que le corpus d’entraînement.
- Aborder la question de la variabilité avec le client seulement en cas de contestation.